# Paquetes necesarios
library(survival)      # Análisis de supervivencia
library(survminer)     # Visualización
library(flexsurv)      # Modelos paramétricos flexibles
library(KMsurv)        # Datasets de supervivencia
library(ggplot2)       # Gráficos
library(dplyr)         # Manipulación de datos
library(knitr)         # Tablas
library(rms)           # Regresión y modelización
library(cmprsk)        # Riesgos competitivos

# Configuración de gráficos
theme_set(theme_minimal())Tutorial de Análisis de Supervivencia en R
Métodos estadísticos para datos de tiempo hasta el evento
Resumen
Este tutorial presenta una introducción exhaustiva al análisis de supervivencia, cubriendo desde conceptos fundamentales hasta técnicas avanzadas de modelización. El análisis de supervivencia es una rama de la estadística que estudia el tiempo hasta que ocurre un evento de interés, considerando la presencia de datos censurados. Se presentan métodos no paramétricos (Kaplan-Meier), semiparamétricos (Cox) y paramétricos (Weibull, exponencial), con ejemplos prácticos implementados en R.
Palabras clave
análisis de supervivencia, survival analysis, Kaplan-Meier, modelo de Cox, censura, riesgo proporcional, modelos paramétricos, bioestadística, epidemiología, tiempo hasta el evento, riesgos competitivos, R
Miguel Ángel Luque Fernández · Departamento de Estadística e Investigación Operativa, Universidad de Granada
Sitio web · GitHub · ORCID · Google Scholar · Universidad de Granada
1 Introducción
1.1 ¿Qué es el análisis de supervivencia?
El análisis de supervivencia es un conjunto de métodos estadísticos diseñados para analizar datos donde la variable de interés es el tiempo hasta que ocurre un evento. Aunque el término proviene de estudios médicos donde el evento de interés es la muerte, estos métodos se aplican ampliamente en:
- Medicina: tiempo hasta recaída, muerte, recuperación
- Ingeniería: tiempo hasta fallo de un componente
- Economía: duración del desempleo, permanencia en un trabajo
- Ciencias sociales: duración de matrimonios, tiempo hasta reincidencia criminal
En términos prácticos, el objetivo suele ser doble: (1) describir cómo cambia la probabilidad de seguir libre de evento con el tiempo (p.ej., curvas Kaplan–Meier) y (2) cuantificar el efecto de covariables sobre el riesgo de evento (p.ej., modelo de Cox). Un punto clave es que el análisis no se basa en “promedios del tiempo” solamente, sino en la estructura temporal y en cómo la censura altera (o no) la información disponible.
1.2 Características especiales de los datos de supervivencia
Los datos de supervivencia presentan dos características distintivas:
- Positividad: Los tiempos de supervivencia son siempre positivos (\(T > 0\))
- Censura: No siempre observamos el evento de interés para todos los sujetos
1.3 Censura
La censura es la característica más importante que distingue al análisis de supervivencia de otros métodos estadísticos. Un dato está censurado cuando no observamos el tiempo exacto del evento.
Interpretación humana: si durante el seguimiento un paciente “sale del radar” (por ejemplo, porque el estudio termina o porque se pierde el contacto), no sabemos cuándo habría ocurrido el evento, pero sí sabemos que todavía no había ocurrido antes de ese momento. Esa información “parcial” es la que los métodos de supervivencia aprenden a usar, y por eso las curvas y los tests no se pueden replicar con técnicas estándar para datos completos.
1.3.1 Tipos de censura
1.3.1.1 Censura por la derecha
El tipo más común. Ocurre cuando:
- El estudio termina antes de que ocurra el evento
- El sujeto se pierde durante el seguimiento
- El sujeto experimenta un evento competitivo
Notación: Si \(T_i\) es el verdadero tiempo de supervivencia y \(C_i\) el tiempo de censura, observamos:
\[Y_i = \min(T_i, C_i)\]
y el indicador de censura:
\[\delta_i = \begin{cases} 1 & \text{si } T_i \leq C_i \text{ (evento observado)} \\ 0 & \text{si } T_i > C_i \text{ (censurado)} \end{cases}\]
1.3.1.2 Censura por la izquierda
Ocurre cuando el evento ya ha ocurrido antes del inicio del estudio. Menos común en práctica.
1.3.1.3 Censura por intervalo
El evento ocurre en un intervalo conocido \((L_i, R_i]\) pero no se conoce el tiempo exacto.
1.3.2 Supuesto fundamental: censura independiente
La validez de los métodos de este tutorial (Kaplan-Meier, log-rank, Cox) descansa en el supuesto de censura independiente (o no informativa): condicional a las covariables observadas, la censura no debe contener información sobre el tiempo del evento. Es decir, los sujetos censurados en el tiempo \(t\) deben ser representativos de los que permanecen en riesgo. La censura administrativa (fin del estudio) suele ser no informativa, mientras que la pérdida de seguimiento por empeoramiento clínico puede violar este supuesto y sesgar las estimaciones (1,2).
1.4 Configuración del entorno
2 Conceptos fundamentales
Las cuatro funciones que definimos a continuación son cuatro formas equivalentes de describir el mismo fenómeno: el tiempo \(T\) hasta que ocurre el evento. Cada una responde a una pregunta clínica distinta y, por tanto, resulta útil en un contexto diferente. Entenderlas juntas —y saber pasar de una a otra— es la base de todo lo que sigue (Kaplan–Meier, Cox, modelos paramétricos).
| Función | Símbolo | Pregunta que responde | Rango | Utilidad práctica |
|---|---|---|---|---|
| Supervivencia | \(S(t)\) | ¿Qué fracción sigue sin evento más allá de \(t\)? | \([0,1]\), decreciente | Pronóstico; comparar grupos (curvas Kaplan–Meier) |
| Densidad | \(f(t)\) | ¿Con qué intensidad caen los eventos alrededor de \(t\)? | \(\ge 0\) | Describir el patrón temporal de los fallos |
| Riesgo (hazard) | \(h(t)\) | ¿Cuál es el peligro instantáneo ahora, para quienes siguen en riesgo? | \(\ge 0\) (es una tasa) | Modelar el mecanismo (riesgo creciente/decreciente/constante); base del modelo de Cox |
| Riesgo acumulado | \(H(t)\) | ¿Cuánto peligro se ha acumulado hasta \(t\)? | \(\ge 0\), creciente | Puente matemático \(S(t)=e^{-H(t)}\); base de Nelson–Aalen |
En esencia: \(S(t)\) y \(f(t)\) describen qué se observa (la curva de supervivencia y cómo se reparten los eventos en el tiempo), mientras que \(h(t)\) y \(H(t)\) describen el mecanismo del proceso (la intensidad instantánea del riesgo y su acumulación). Por eso, cuando un clínico quiere predecir o comparar pronósticos mira \(S(t)\); cuando un modelo quiere explicar por qué un grupo falla antes que otro, modela \(h(t)\).
2.1 Función de supervivencia
La función de supervivencia \(S(t)\) define la probabilidad de que un individuo sobreviva más allá del tiempo \(t\):
Lectura intuitiva: \(S(t)\) responde a la pregunta “si el paciente ha llegado hasta (o más allá de) el tiempo 0, ¿qué fracción esperada seguiría sin evento después del tiempo \(t\)?”. En presencia de censura, \(S(t)\) no se “cuenta” directamente como proporción cruda, sino que se estima usando información de quién permaneció en riesgo.
\[S(t)=P(T>t)=1-F(t),\qquad F(t)=P(T\le t).\]
Propiedades:
- \(S(0)=1\) (todos están vivos al inicio)
- \(S(\infty)=0\) (eventualmente todos experimentan el evento)
- \(S(t)\) es una función decreciente y continua por la derecha
2.2 Función de densidad
La función de densidad \(f(t)\) se define como probabilidad por unidad de tiempo en un intervalo infinitesimal:
\[f(t)=\lim_{\Delta t\to 0}\frac{P(t\le T<t+\Delta t)}{\Delta t}.\]
2.2.1 Derivación de \(f(t)=\frac{dF(t)}{dt}\)
Como \(P(t\le T<t+\Delta t)=F(t+\Delta t)-F(t)\),
\[f(t)=\lim_{\Delta t\to 0}\frac{F(t+\Delta t)-F(t)}{\Delta t}=\frac{dF(t)}{dt}.\]
2.2.2 Derivación de \(f(t)=-\frac{dS(t)}{dt}\)
Dado que \(S(t)=1-F(t)\),
\[\frac{dS(t)}{dt}=-\frac{dF(t)}{dt}=-f(t)\quad\Rightarrow\quad f(t)=-\frac{dS(t)}{dt}.\]
2.3 Función de riesgo (hazard)
La función de riesgo \(h(t)\) es la tasa instantánea de ocurrencia del evento en \(t\), condicionada a que el individuo ya ha sobrevivido hasta \(t\):
\[h(t)=\lim_{\Delta t\to 0}\frac{P(t\le T<t+\Delta t\mid T\ge t)}{\Delta t}.\]
2.3.1 Derivación de \(h(t)=\frac{f(t)}{S(t)}\)
Paso 1 (probabilidad condicional)
\[P(t\le T<t+\Delta t\mid T\ge t)=\frac{P(t\le T<t+\Delta t)}{P(T\ge t)}=\frac{P(t\le T<t+\Delta t)}{S(t)}.\]
Paso 2 (sustituir en el límite)
\[h(t)=\lim_{\Delta t\to 0}\frac{\frac{P(t\le T<t+\Delta t)}{S(t)}}{\Delta t}=\frac{1}{S(t)}\lim_{\Delta t\to 0}\frac{P(t\le T<t+\Delta t)}{\Delta t}=\frac{f(t)}{S(t)}.\]
2.3.2 Derivación de \(h(t)=-\frac{d}{dt}\log S(t)\)
Como \(f(t)=-\frac{dS(t)}{dt}\),
\[h(t)=\frac{-S'(t)}{S(t)}=-\frac{d}{dt}\log S(t).\]
Interpretación: \(h(t)\) es una tasa (eventos por unidad de tiempo), no una probabilidad. Por tanto no está acotada en \([0,1]\) y típicamente \(h(t)\ge 0\) (3).
2.4 Función de riesgo acumulado
La función de riesgo acumulado \(H(t)\) agrega el hazard desde 0 hasta \(t\):
\[H(t)=\int_0^t h(u)\,du.\]
2.4.1 Derivación de \(S(t)=\exp(-H(t))\)
Partimos de
\[h(t)=-\frac{d}{dt}\log S(t).\]
Reordenando e integrando desde 0 hasta \(t\):
\[\log S(t)-\log S(0)=-\int_0^t h(u)\,du=-H(t).\]
Como \(S(0)=1\) (luego \(\log S(0)=0\)), queda
\[S(t)=\exp(-H(t))=\exp\left(-\int_0^t h(u)\,du\right).\]
2.5 Relaciones entre funciones
\[\begin{aligned} S(t) &= \exp\left(-\int_0^t h(u)\,du\right) \\ f(t) &= h(t)S(t) \\ h(t) &= \frac{f(t)}{S(t)}=-\frac{d}{dt}\log S(t) \\ H(t) &= \int_0^t h(u)\,du=-\log S(t) \end{aligned}\]
2.5.1 Visualización de las cuatro funciones
El siguiente ejemplo ilustra las cuatro funciones para una distribución Weibull con forma \(\gamma = 2\) (riesgo creciente) y escala \(\lambda = 0.4\). Observa cómo se relacionan: \(S(t)\) desciende de 1 a 0; \(f(t)\) muestra un pico (el momento de mayor “densidad” de eventos); \(h(t)\) crece linealmente (típico de un proceso de envejecimiento); y \(H(t)\) acumula ese riesgo de forma creciente.
# Parámetros de una distribución Weibull (riesgo creciente)
gamma <- 2
lambda <- 0.4

# Rejilla de tiempos de evaluación
t <- seq(0, 8, length.out = 400)

# Cálculo directo de las cuatro funciones
S <- exp(-lambda * t^gamma)
f <- lambda * gamma * t^(gamma - 1) * exp(-lambda * t^gamma)
h <- lambda * gamma * t^(gamma - 1)
H <- lambda * t^gamma

# Panel 2x2
par(mfrow = c(2, 2))
plot(t, S, type = "l", lwd = 2, col = "#1f77b4",
     main = "Supervivencia S(t)", xlab = "Tiempo", ylab = "S(t)")
plot(t, f, type = "l", lwd = 2, col = "#ff7f0e",
     main = "Densidad f(t)", xlab = "Tiempo", ylab = "f(t)")
plot(t, h, type = "l", lwd = 2, col = "#2ca02c",
     main = "Riesgo h(t)", xlab = "Tiempo", ylab = "h(t)")
plot(t, H, type = "l", lwd = 2, col = "#d62728",
     main = "Riesgo acumulado H(t)", xlab = "Tiempo", ylab = "H(t)")
par(mfrow = c(1, 1))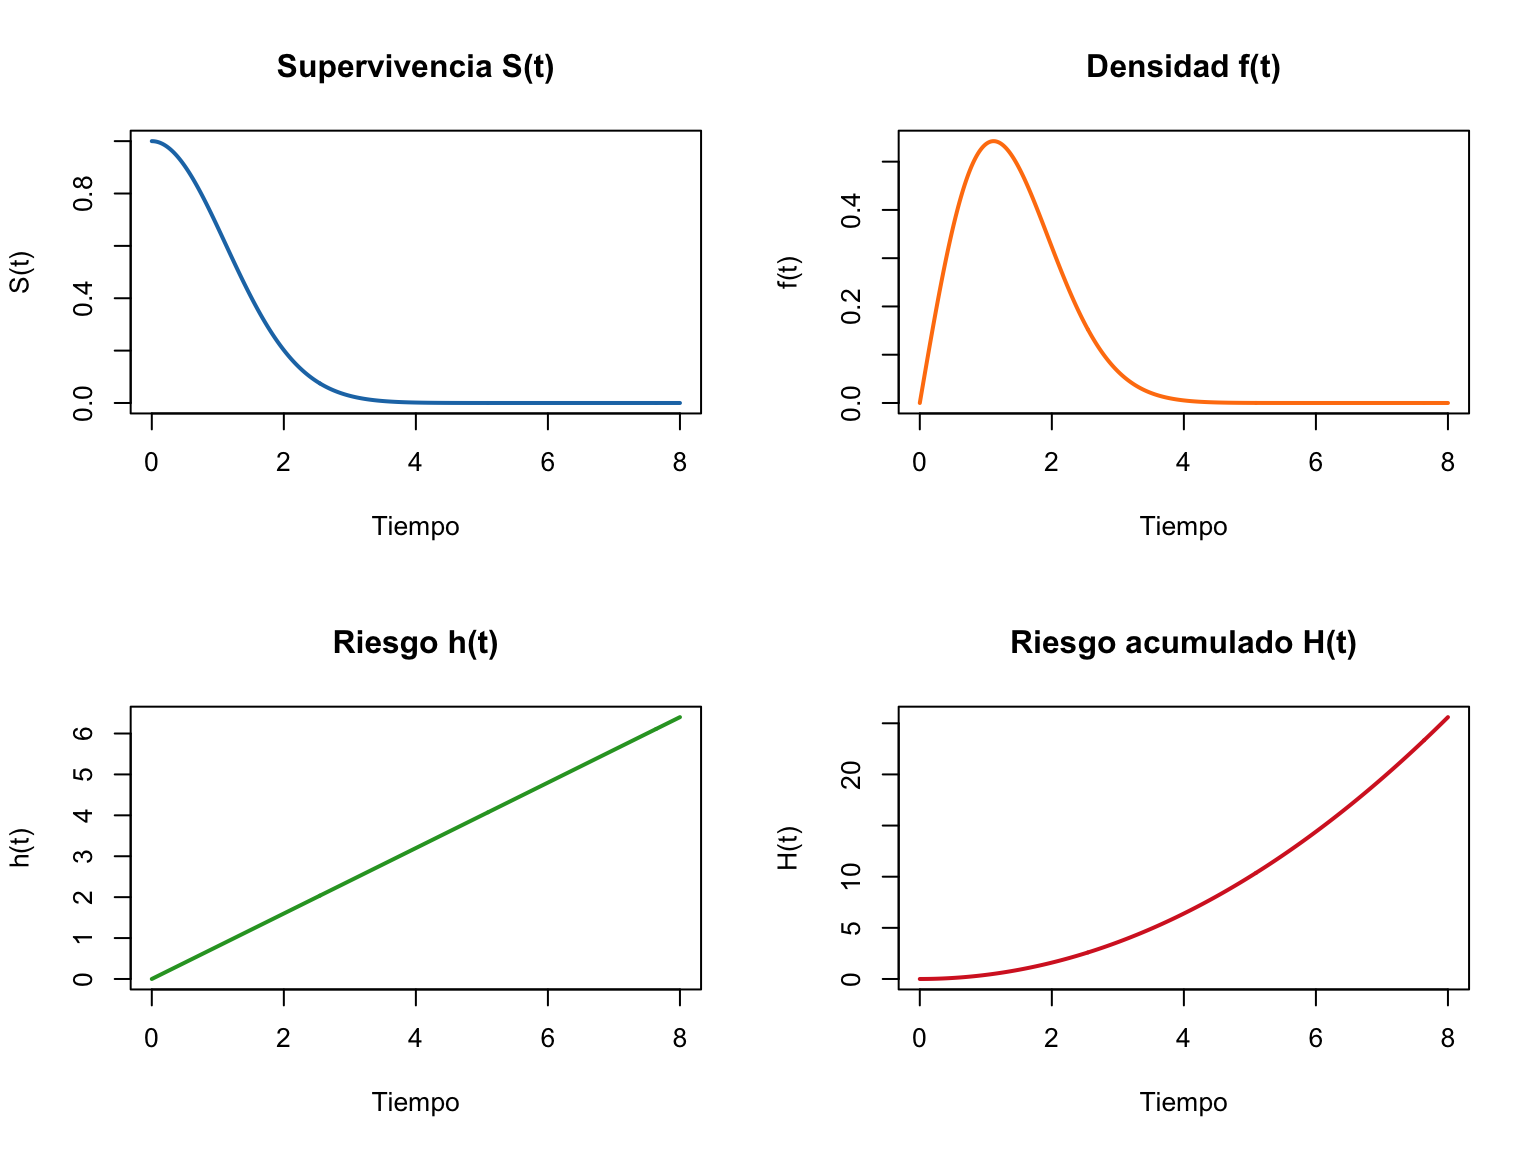
3 Métodos no paramétricos
3.1 Estimador de Kaplan-Meier
El estimador de Kaplan-Meier (4) es el método no paramétrico más utilizado para estimar la función de supervivencia en presencia de censura.
Lectura práctica: la curva KM “salta” únicamente en los tiempos donde se observan eventos (no en los tiempos de censura). La censura, en cambio, influye en la curva porque reduce el denominador (el número en riesgo) a partir de su tiempo de salida.
3.1.1 Construcción del estimador
Sean \(t_1 < t_2 < \cdots < t_k\) los tiempos únicos de eventos observados. En cada tiempo \(t_j\):
- \(d_j\) = número de eventos
- \(n_j\) = número de individuos en riesgo (no han experimentado el evento ni han sido censurados antes de \(t_j\))
El estimador de Kaplan-Meier es:
\[\hat{S}(t) = \prod_{j: t_j \leq t} \left(1 - \frac{d_j}{n_j}\right)\]
Idea intuitiva: para sobrevivir hasta \(t\), el individuo debe “superar” cada uno de los tiempos de evento \(t_j \leq t\). En cada salto, la probabilidad condicional de sobrevivir es \(1 - d_j/n_j\) (los que no experimentan el evento entre los que aún estaban en riesgo). El producto de estas probabilidades condicionales da \(\hat{S}(t)\). Los individuos censurados contribuyen al denominador \(n_j\) (están en riesgo) hasta su censura, pero no generan saltos en la curva: este es el mecanismo por el que el estimador aprovecha la información parcial de la censura (1,4).
3.1.2 Varianza del estimador
La varianza se estima mediante la fórmula de Greenwood (5):
\[\widehat{\text{Var}}[\hat{S}(t)] = \hat{S}(t)^2 \sum_{j: t_j \leq t} \frac{d_j}{n_j(n_j - d_j)}\]
El error estándar es:
\[\widehat{\text{SE}}[\hat{S}(t)] = \sqrt{\widehat{\text{Var}}[\hat{S}(t)]}\]
3.1.3 Intervalos de confianza
El intervalo de confianza al \((1-\alpha)\times 100\%\) para \(S(t)\) se puede construir por dos vías: directamente sobre \(S(t)\) (método lineal) o sobre una transformación que respete su rango \([0,1]\) (método log-log).
Método lineal (puede producir límites fuera de \([0,1]\)):
\[\hat{S}(t) \pm z_{\alpha/2} \times \widehat{\text{SE}}[\hat{S}(t)]\]
Método log-log (recomendado, garantiza \(\hat{S}(t) \in [0,1]\)): se obtiene aplicando el método delta a la transformación \(g(x)=\log(-\log x)\) (1,2).
3.1.3.1 El método delta
El método delta es una técnica general para aproximar la varianza de una función \(g\) de un estimador \(\hat{\theta}\) cuando solo conocemos la varianza de \(\hat{\theta}\). Si \(g\) es diferenciable, la aproximación de Taylor de primer orden en torno a \(\theta\) da
\[g(\hat{\theta}) \approx g(\theta) + g'(\theta)\,(\hat{\theta}-\theta),\]
y, tomando varianzas en ambos lados (con \(g(\theta)\) y \(g'(\theta)\) constantes),
\[\text{Var}[g(\hat{\theta})] \approx [g'(\theta)]^2 \, \text{Var}(\hat{\theta}).\]
En la práctica sustituimos \(\theta\) por su estimación \(\hat{\theta}\) y la varianza por su estimador \(\widehat{\text{Var}}(\hat{\theta})\).
3.1.3.2 Aplicación al intervalo log-log
Para que el intervalo nunca salga de \([0,1]\), aplicamos el método delta a la transformación \(g(S)=\log(-\log S)\). Su derivada es
\[g'(S)=\frac{d}{dS}\log(-\log S)=\frac{1}{S\log S}.\]
Como \(S\in(0,1)\), se cumple \(\log S<0\), de modo que \(|g'(S)|=\dfrac{1}{S\,|\log S|}\). Aplicando el método delta,
\[\widehat{\text{SE}}\left[\log(-\log \hat{S})\right] = \frac{\widehat{\text{SE}}[\hat{S}]}{\hat{S}\,|\log \hat{S}|}.\]
A continuación, el intervalo de confianza se construye en dos pasos (1,2):
Paso 1 — Intervalo en la escala log-log. Se forma el intervalo del \((1-\alpha)\times 100\%\) para \(\log(-\log S(t))\):
\[\log(-\log \hat{S}(t)) \pm z_{\alpha/2}\,\sqrt{\widehat{\text{Var}}\Big(\log(-\log \hat{S}(t))\Big)}.\]
Sustituyendo la varianza que da el método delta, este intervalo equivale a
\[\log(-\log \hat{S}(t)) \pm z_{\alpha/2}\, \frac{\widehat{\text{SE}}[\hat{S}(t)]}{\hat{S}(t)\,|\log \hat{S}(t)|}.\]
Sus dos extremos se denotan como límite inferior \(\text{CI}_{\text{lower}}\) y superior \(\text{CI}_{\text{upper}}\), ambos en la escala log-log.
Paso 2 — Volver a la escala de supervivencia. Se transforman los límites mediante doble exponenciación, invirtiendo \(g(S)=\log(-\log S)\), es decir, aplicando \(S=\exp(-\exp(\cdot))\). Como \(g\) es decreciente, el límite superior de la escala log-log se convierte en el límite inferior de la escala original y viceversa:
\[\text{IC}=\Big(\exp\big(-\exp(\text{CI}_{\text{upper}})\big),\ \exp\big(-\exp(\text{CI}_{\text{lower}})\big)\Big).\]
Desarrollando los dos extremos, el intervalo se escribe de forma compacta como
\[\hat{S}(t)^{\exp\left(\pm\, z_{\alpha/2}\, \dfrac{\widehat{\text{SE}}[\hat{S}(t)]}{\hat{S}(t)\,|\log \hat{S}(t)|}\right)}.\]
Este intervalo está siempre dentro de \([0,1]\) y es asimétrico, lo que refleja mejor la forma de la distribución muestral de \(\hat{S}(t)\) en las colas.
3.1.4 Ejemplo: datos de leucemia
Utilizamos los datos clásicos de Freireich et al. (6) sobre tiempos de remisión en leucemia aguda, que comparan dos grupos de tratamiento (quimioterapia mantenida frente a no mantenida).
# Cargar datos
data(aml, package = "survival")

# Asegurar consistencia del grupo (y evitar colapso a una sola curva)
aml <- aml[!is.na(aml$x), ]
aml$x <- factor(aml$x)

# Crear objeto de supervivencia
km_fit <- survfit(Surv(time, status) ~ x, data = aml)

# Resumen
summary(km_fit)
Call: survfit(formula = Surv(time, status) ~ x, data = aml)
x=Maintained
time n.risk n.event survival std.err lower 95% CI upper 95% CI
9 11 1 0.909 0.0867 0.7541 1.000
13 10 1 0.818 0.1163 0.6192 1.000
18 8 1 0.716 0.1397 0.4884 1.000
23 7 1 0.614 0.1526 0.3769 0.999
31 5 1 0.491 0.1642 0.2549 0.946
34 4 1 0.368 0.1627 0.1549 0.875
48 2 1 0.184 0.1535 0.0359 0.944
x=Nonmaintained
time n.risk n.event survival std.err lower 95% CI upper 95% CI
5 12 2 0.8333 0.1076 0.6470 1.000
8 10 2 0.6667 0.1361 0.4468 0.995
12 8 1 0.5833 0.1423 0.3616 0.941
23 6 1 0.4861 0.1481 0.2675 0.883
27 5 1 0.3889 0.1470 0.1854 0.816
30 4 1 0.2917 0.1387 0.1148 0.741
33 3 1 0.1944 0.1219 0.0569 0.664
43 2 1 0.0972 0.0919 0.0153 0.620
45 1 1 0.0000 NaN NA NA# Gráfico
n_strata <- length(km_fit$strata)
legend_labs <- if (n_strata == 2) c("Mantenido", "No mantenido") else NULL
ggsurvplot(
km_fit,
data = aml,
pval = TRUE,
conf.int = TRUE,
risk.table = TRUE,
xlab = "Tiempo (semanas)",
ylab = "Probabilidad de supervivencia",
title = "Curvas de Kaplan-Meier por grupo de tratamiento",
legend.title = "Grupo",
legend.labs = legend_labs,
ggtheme = theme_minimal()
)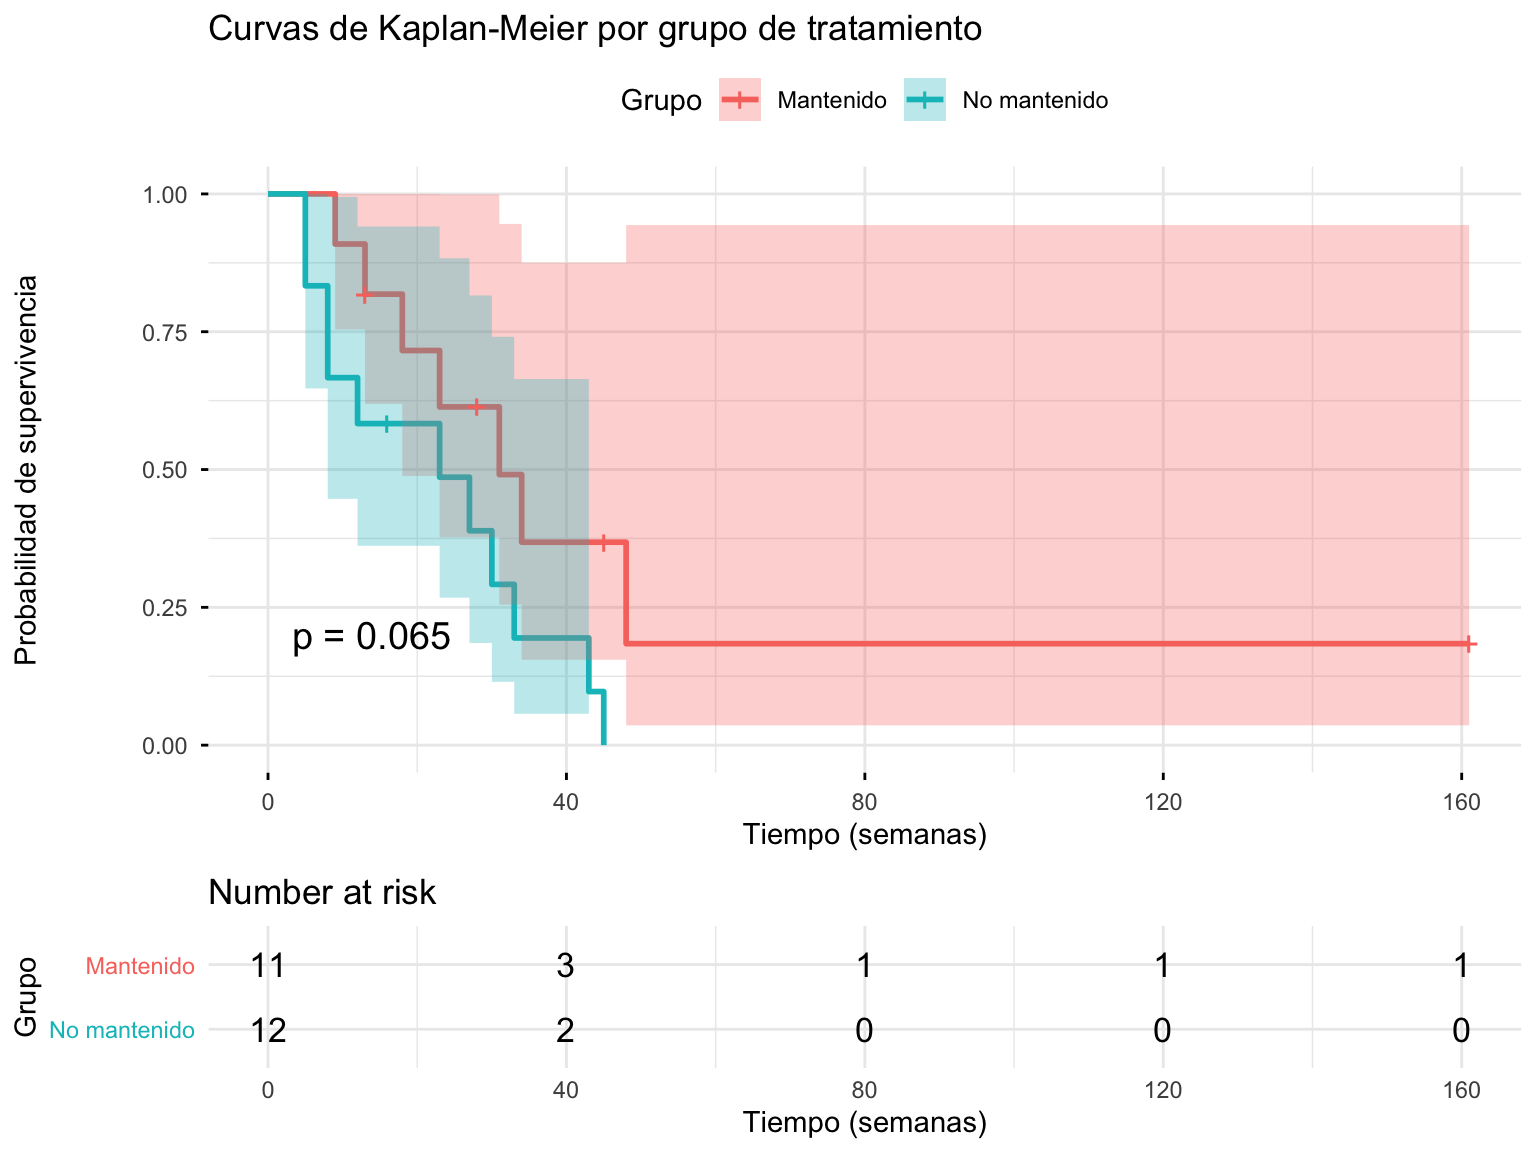
Cómo leer la salida de summary(km_fit): R imprime, para cada grupo, una tabla por tiempos de evento con las columnas time, n.risk, n.event, survival, std.err y los límites del IC95%. Conviene fijarse en tres detalles: (1) survival solo cae en los tiempos con n.event > 0 (las censuras no producen saltos); (2) n.risk desciende también por las censuras, no solo por los eventos; y (3) el error estándar crece hacia el final del seguimiento porque cada vez quedan menos personas en riesgo, de modo que el IC se abre más cuando queda poca gente.
3.1.5 Tiempo de supervivencia mediano
El tiempo de supervivencia mediano es el tiempo \(t_{0.5}\) tal que:
\[\hat{S}(t_{0.5}) = 0.5\]
# Calcular medianas
print(km_fit, print.rmean = TRUE)
Call: survfit(formula = Surv(time, status) ~ x, data = aml)
n events rmean* se(rmean) median 0.95LCL 0.95UCL
x=Maintained 11 7 52.6 19.83 31 18 NA
x=Nonmaintained 12 11 22.7 4.18 23 8 NA
* restricted mean with upper limit = 161 Cómo leer esta salida: la tabla muestra, por grupo, el número de sujetos (n), de eventos (events), la mediana de supervivencia y su IC95%. La mediana es el tiempo en que \(\hat S(t)\) cruza 0.5. Cuando la curva nunca llega a 0.5 dentro del seguimiento, R devuelve NA: no es un error, sino una señal de que la supervivencia es alta y la mediana no es estimable con esos datos. Por eso también se reporta la media restringida (*rmean), que es el área bajo la curva hasta un límite de tiempo y puede estimarse aunque la mediana no exista.
3.2 Comparación de curvas de supervivencia
3.2.1 Test de log-rank
El test de log-rank (7) compara dos o más curvas de supervivencia. Es el más utilizado y da peso igual a todos los tiempos.
Interpretación de salida: si el test devuelve un p-valor pequeño, la lectura estadística habitual es “hay evidencia de que las curvas no provienen del mismo proceso generador de riesgos”; en términos de riesgos proporcionales, sugiere que la razón de riesgos entre grupos no es la misma a través del tiempo (o, más exactamente, que la hipótesis de igualdad de hazard no se sostiene con la información censurada disponible).
Propiedad importante: el test de log-rank equivale al score test del modelo de Cox con una única covariable indicadora de grupo, por lo que es óptimo (máxima potencia) cuando la razón de riesgos entre grupos es constante en el tiempo, es decir, bajo la asunción de riesgos proporcionales (2,3).
Hipótesis:
- \(H_0\): Las funciones de riesgo son iguales en todos los grupos (\(h_1(t) = h_2(t) = \cdots = h_K(t)\))
- \(H_1\): Al menos una función de riesgo es diferente
Estadístico de prueba: Sea \(O_{kj}\) el número observado de eventos en el grupo \(k\) en el tiempo \(t_j\), y \(E_{kj}\) el número esperado bajo \(H_0\):
\[E_{kj} = n_{kj} \times \frac{d_j}{n_j}\]
El estadístico de log-rank es:
\[\chi^2 = \sum_{k=1}^K \frac{(O_k - E_k)^2}{E_k} \sim \chi^2_{K-1}\]
donde \(O_k = \sum_j O_{kj}\) y \(E_k = \sum_j E_{kj}\).
Generalización (familia de tests ponderados): los tests de log-rank, Wilcoxon y Tarone-Ware son casos particulares de la misma familia estadística,
\[\chi^2_W = \left(\sum_j w_j (O_{1j} - E_{1j})\right)^2 \Big/ \sum_j w_j^2 \, \text{Var}(O_{1j} - E_{1j}),\]
que se distinguen por el peso \(w_j\) asignado a cada tiempo \(t_j\):
- Log-rank: \(w_j = 1\) (igual peso; óptimo bajo riesgos proporcionales)
- Wilcoxon (Peto-Peto): \(w_j = n_j\) (más peso a tiempos tempranos) (8)
- Tarone-Ware: \(w_j = \sqrt{n_j}\) (compromiso intermedio)
# Test de log-rank
survdiff(Surv(time, status) ~ x, data = aml)
Call:
survdiff(formula = Surv(time, status) ~ x, data = aml)
N Observed Expected (O-E)^2/E (O-E)^2/V
x=Maintained 11 7 10.69 1.27 3.4
x=Nonmaintained 12 11 7.31 1.86 3.4
Chisq= 3.4 on 1 degrees of freedom, p= 0.07 Cómo leer survdiff: la salida da N (sujetos por grupo), Observed (eventos observados), Expected (eventos que cabría esperar bajo \(H_0\) si los riesgos fueran iguales), las contribuciones \((O-E)^2/E\) y \((O-E)^2/V\), y al final Chisq con sus grados de libertad y el p-valor. La clave está en comparar observados frente a esperados: si un grupo acumula muchos más eventos de los esperados, el estadístico crece y el p-valor baja. Un p-valor pequeño (habitualmente < 0.05) nos lleva a rechazar la igualdad de curvas.
3.2.2 Test de Wilcoxon-Breslow-Gehan
Variante que da más peso a tiempos tempranos (8):
\[W = \sum_{k=1}^K \sum_j n_j (O_{kj} - E_{kj})\]
# Test de Wilcoxon
survdiff(Surv(time, status) ~ x, data = aml, rho = 1)
Call:
survdiff(formula = Surv(time, status) ~ x, data = aml, rho = 1)
N Observed Expected (O-E)^2/E (O-E)^2/V
x=Maintained 11 3.85 6.14 0.859 2.78
x=Nonmaintained 12 7.18 4.88 1.081 2.78
Chisq= 2.8 on 1 degrees of freedom, p= 0.1 Nota sobre la lectura: el formato es idéntico al del log-rank, pero rho = 1 pondera más los tiempos tempranos (los eventos que ocurren pronto pesan más). Si este test da evidencia distinta a la del log-rank, suele indicar que la diferencia entre grupos se concentra al principio del seguimiento y se diluye después.
3.2.3 Test de Tarone-Ware
Compromiso entre log-rank y Wilcoxon, usando pesos \(w_j = \sqrt{n_j}\).
3.3 Estimador de Nelson-Aalen
Alternativa al estimador de Kaplan-Meier, estima directamente el riesgo acumulado (9,10):
\[\hat{H}(t) = \sum_{j: t_j \leq t} \frac{d_j}{n_j}\]
donde \(d_j/n_j\) es el incremento de riesgo en el tiempo \(t_j\) (número de eventos dividido por el número de individuos en riesgo). A partir de él, la función de supervivencia se estima como:
\[\hat{S}(t) = \exp(-\hat{H}(t))\]
Relación con Kaplan-Meier: para muestras pequeñas, \(\hat{S}_{NA}(t) = \exp(-\hat{H}(t))\) es mayor o igual que el estimador de Kaplan-Meier, y ambos convergen asintóticamente. La fórmula de Greenwood y la de Nelson-Aalen se pueden ver como dos aproximaciones distintas de la misma varianza del logaritmo del riesgo acumulado. El estimador de Nelson-Aalen es la base del estimador de Breslow (11) de la función de riesgo basal en el modelo de Cox.
# Estimador de Kaplan-Meier (muestra completa, sin estratificar)
km_all <- survfit(Surv(time, status) ~ 1, data = aml)

# Estimador de Nelson-Aalen (Fleming-Harrington)
na_fit <- survfit(Surv(time, status) ~ 1, data = aml, type = "fh")

# Comparación
par(mfrow = c(1, 2))
plot(km_all, conf.int = FALSE, main = "Kaplan-Meier", xlab = "Tiempo", ylab = "S(t)")
plot(na_fit, conf.int = FALSE, main = "Nelson-Aalen", xlab = "Tiempo", ylab = "S(t)")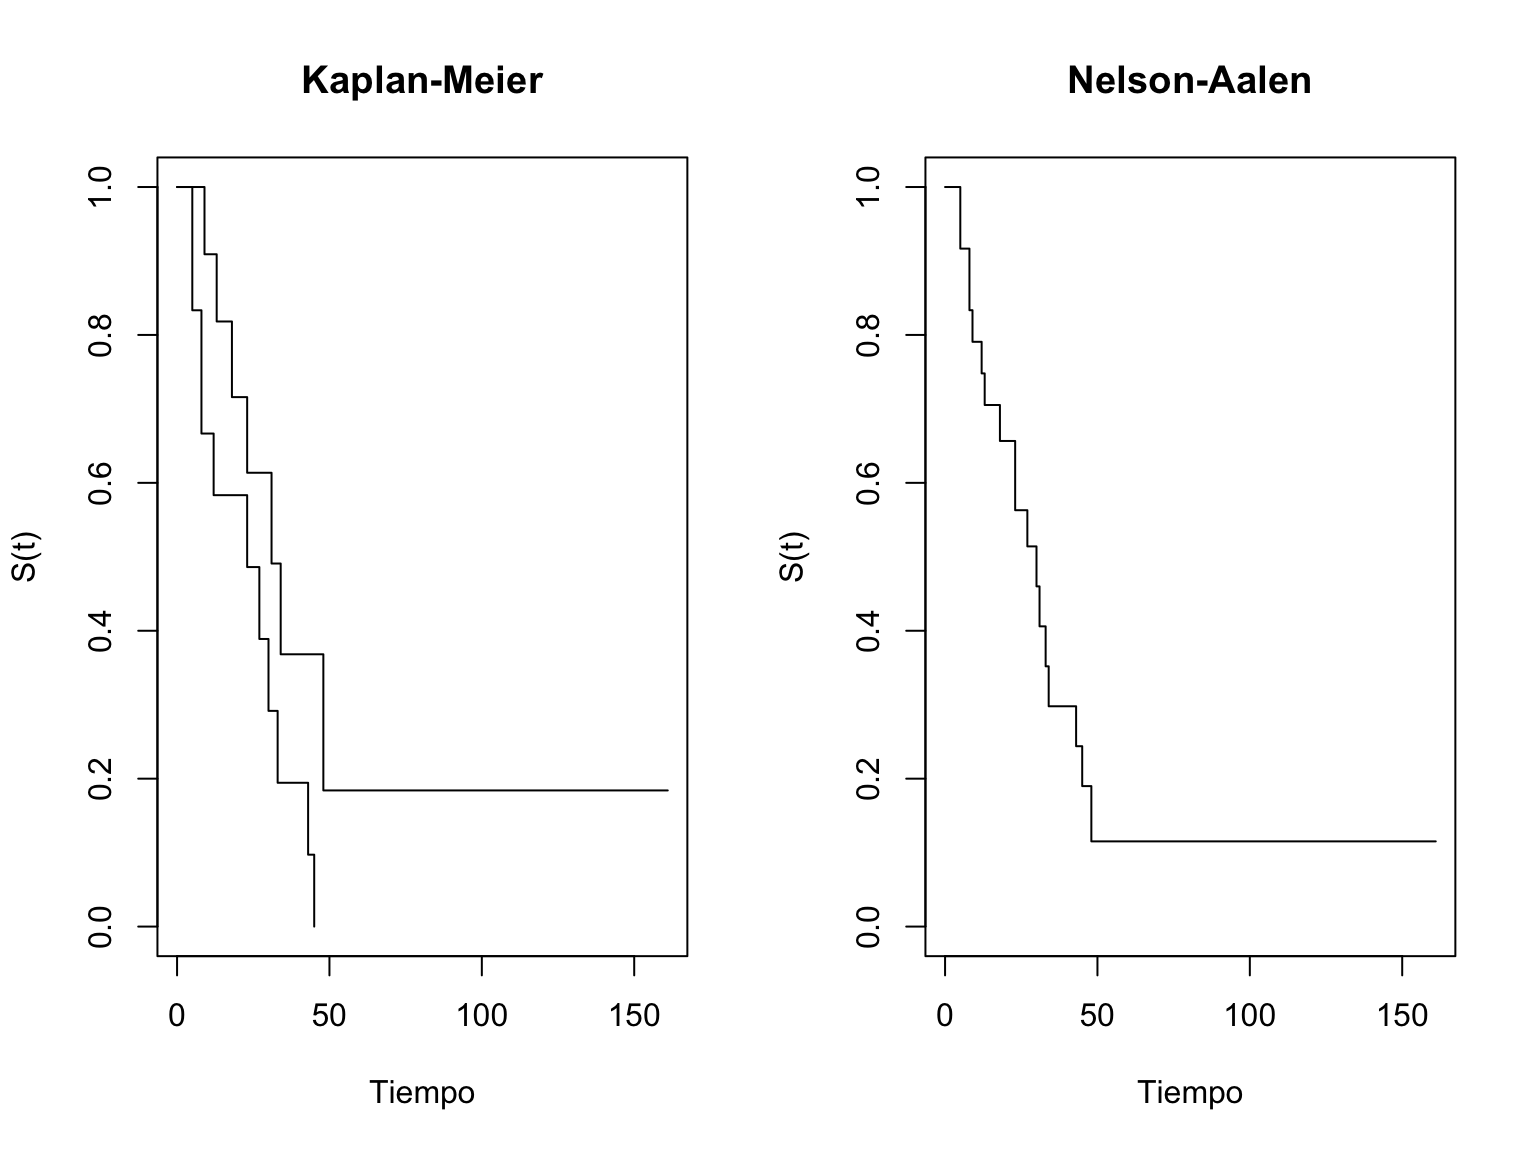
3.4 Estimación del riesgo acumulado \(H(t)\)
El riesgo acumulado \(H(t)\) —también llamado densidad de incidencia acumulada— mide cuánta “intensidad de evento” se ha acumulado desde \(0\) hasta \(t\). En epidemiología, la tasa \(h(t)\) es la densidad de incidencia instantánea (eventos por persona-tiempo en el instante \(t\)), y \(H(t)\) es esa misma densidad integrada a lo largo del tiempo:
\[H(t)=\int_0^t h(u)\,du.\]
Si el hazard fuera constante e igual a \(\lambda\) (modelo exponencial), entonces \(H(t)=\lambda t\): el riesgo acumulado crecería linealmente con la pendiente igual a la tasa de incidencia.
3.4.1 Dos estimadores no paramétricos de \(H(t)\)
A diferencia de \(S(t)\) (estimada directamente con Kaplan-Meier), \(H(t)\) admite dos estimadores no paramétricos equivalentes asintóticamente:
Vía Kaplan-Meier. Como \(S(t)=\exp(-H(t))\), se deduce
\[\hat{H}_{KM}(t) = -\log \hat{S}_{KM}(t).\]
Es el “logaritmo negativo” de la curva de Kaplan-Meier.
Nelson-Aalen. Estima \(H(t)\) directamente sumando los incrementos de riesgo \(d_j/n_j\) (9,10):
\[\hat{H}_{NA}(t) = \sum_{j: t_j \le t} \frac{d_j}{n_j}.\]
3.4.2 Interpretación
- \(\hat{H}_{NA}(t)\) acumula la razón eventos/en-riesgo en cada tiempo de evento: en cada salto se suma \(d_j/n_j\), la proporción de sujetos que experimenta el evento en \(t_j\) entre los que llegaron vivos a ese instante.
- \(\hat{H}_{KM}(t)\) transforma la supervivencia estimada; como \(-\log x \approx 1-x\) cuando \(x\) está cerca de 1, si los saltos son pequeños ambos estimadores coinciden casi exactamente.
- Un \(H(t)\) grande indica mucho “riesgo acumulado” (y por tanto \(S(t)\) bajo). A diferencia de \(S(t)\in[0,1]\), \(H(t)\) no está acotado por arriba: puede superar 1 cuando el riesgo acumulado es elevado.
3.4.3 Diferencias entre \(\hat{H}_{KM}\) y \(\hat{H}_{NA}\)
- Orden: para muestras finitas, \(\hat{H}_{KM}(t)=-\log\hat{S}_{KM}(t)\) es ligeramente mayor o igual que \(\hat{H}_{NA}(t)\) y, en consecuencia, la supervivencia de Nelson-Aalen \(\hat{S}_{NA}(t)=\exp(-\hat{H}_{NA}(t))\) es mayor o igual que la de Kaplan-Meier \(\hat{S}_{KM}(t)\). La diferencia es de segundo orden y se desvanece asintóticamente.
- Salto: \(\hat{H}_{NA}(t)\) salta \(d_j/n_j\), mientras que \(\hat{H}_{KM}(t)\) salta \(-\log(1-d_j/n_j)\). Como \(-\log(1-x)\ge x\) para \(x\in[0,1)\), el salto de la versión KM es mayor, y por eso \(\hat{H}_{KM}\) queda por encima de \(\hat{H}_{NA}\). Equivalentemente, \(\prod_j(1-d_j/n_j)\le \exp(-\sum_j d_j/n_j)\), es decir, \(\hat{S}_{KM}(t)\le \hat{S}_{NA}(t)\).
- Base teórica: Nelson-Aalen es la base del estimador de Breslow del hazard basal en el modelo de Cox (11); Kaplan-Meier es la referencia clásica para \(S(t)\).
3.4.4 Cálculo en R
data(aml, package = "survival")
aml <- aml[!is.na(aml$x), ]

# Kaplan-Meier (supervivencia) y su transformación a riesgo acumulado
km_all <- survfit(Surv(time, status) ~ 1, data = aml)
H_km <- -log(km_all$surv)

# Nelson-Aalen (riesgo acumulado directo)
na_fit <- survfit(Surv(time, status) ~ 1, data = aml, type = "fh")
H_na <- na_fit$cumhaz

# Gráfico superpuesto (funciones escalón)
plot(c(0, na_fit$time), c(0, H_na), type = "s", col = "#d62728", lwd = 2,
     xlab = "Tiempo", ylab = "Riesgo acumulado H(t)",
     main = "H(t): Nelson-Aalen vs Kaplan-Meier")
lines(c(0, km_all$time), c(0, H_km), type = "s", col = "#1f77b4", lwd = 2)
legend("topleft", legend = c("Nelson-Aalen", "Kaplan-Meier (−log S)"),
       col = c("#d62728", "#1f77b4"), lwd = 2)

# Comparación numérica en los primeros tiempos de evento
head(cbind(tiempo = km_all$time,
           H_NA = round(na_fit$cumhaz, 3),
           H_KM = round(-log(km_all$surv), 3)), 10)
tiempo H_NA H_KM
[1,] 5 0.089 0.091
[2,] 8 0.187 0.191
[3,] 9 0.239 0.245
[4,] 12 0.295 0.302
[5,] 13 0.354 0.363
[6,] 16 0.354 0.363
[7,] 18 0.425 0.437
[8,] 23 0.585 0.604
[9,] 27 0.676 0.699
[10,] 28 0.676 0.699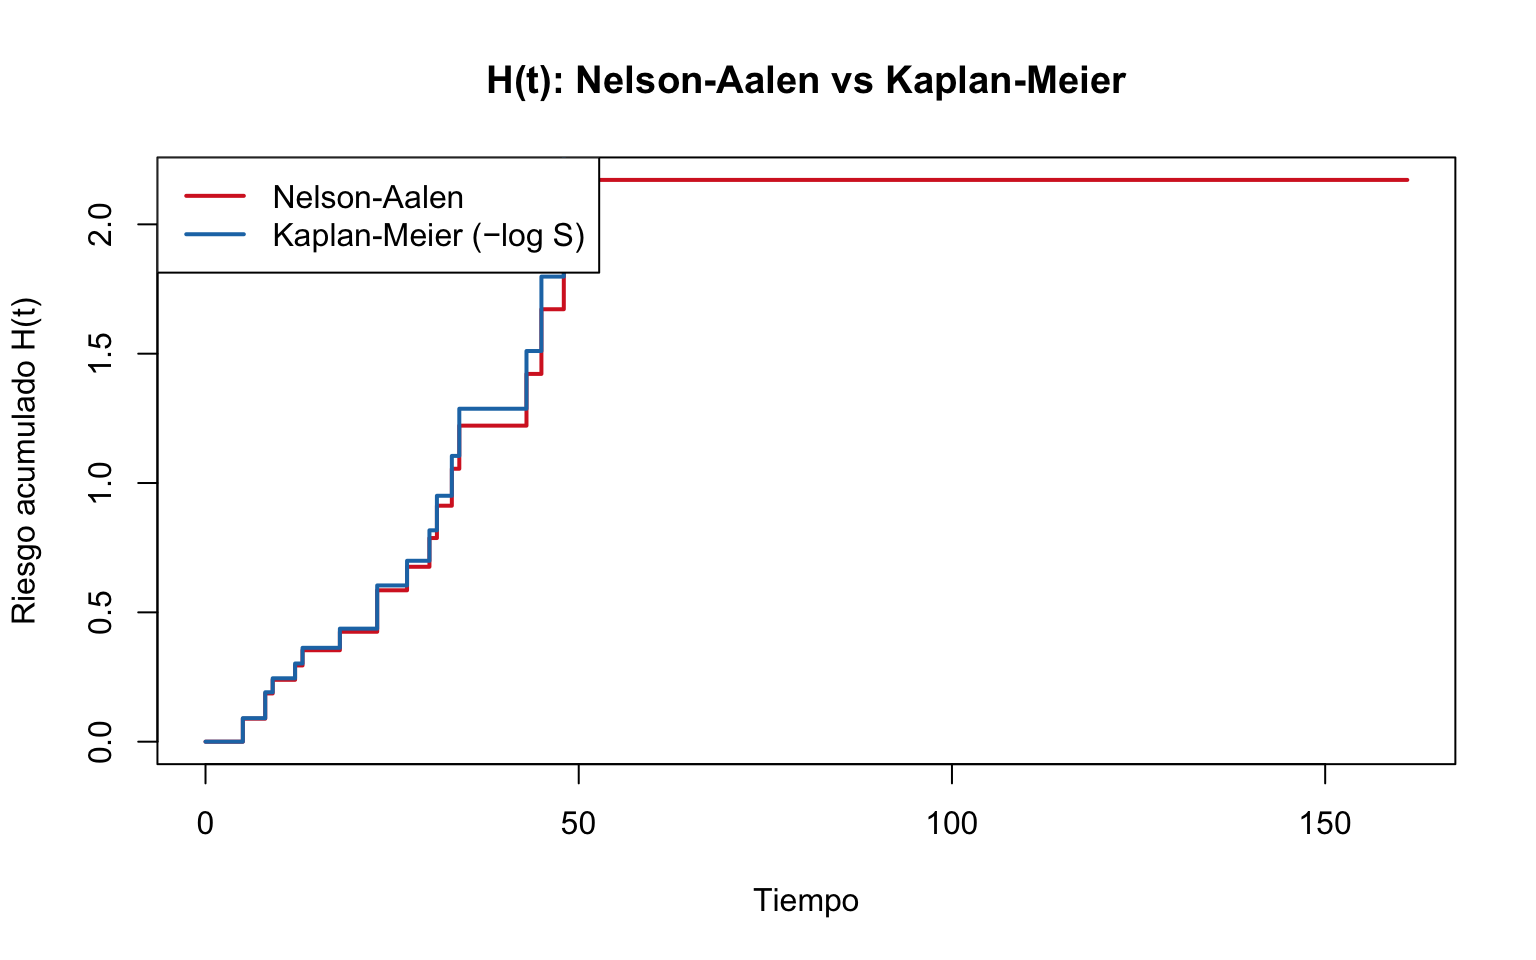
Cómo leer la salida: las dos curvas son prácticamente indistinguibles (saltan en los mismos tiempos de evento), pero la transformación de Kaplan-Meier (azul) queda ligeramente por encima de Nelson-Aalen (rojo). La tabla confirma que, tiempo a tiempo, \(H_{NA}\) queda apenas por debajo de \(H_{KM}\), y que ambas crecen de forma monótona acumulando \(d_j/n_j\) (o su transformación logarítmica).
4 Modelos paramétricos
Los modelos paramétricos asumen que los tiempos de supervivencia siguen una distribución de probabilidad específica. A diferencia del estimador de Kaplan-Meier (completamente no paramétrico), estos modelos imponen una forma funcional para la función de riesgo, lo que permite extrapolar más allá del último tiempo observado, obtener estimaciones más eficientes (menor varianza) cuando el modelo es correcto y realizar predicciones explícitas de la función de supervivencia.
Todos los modelos ajustados con survreg() en R pertenecen a la clase de modelos de tiempo de fallo acelerado (AFT, accelerated failure time), que se escriben como:
\[\log T_i = \mu + \boldsymbol{\beta}' \mathbf{X}_i + \sigma W_i\]
donde \(W_i\) es un error con distribución fija (normal, valor extremo, logística, etc.) y \(\sigma\) es un parámetro de escala.
Interpretación en escala de tiempo (AFT frente a HR): en survreg, aumentar \(X_k\) en una unidad desplaza \(\log T\) en \(\beta_k\), es decir, multiplica el tiempo hasta el evento por \(\exp(\beta_k)\). Por tanto:
- \(\beta_k > 0\) (es decir, \(\exp(\beta_k) > 1\)) → tiempos más largos, el evento tiende a ocurrir más tarde.
- \(\beta_k < 0\) (\(\exp(\beta_k) < 1\)) → tiempos más cortos, el evento tiende a ocurrir antes.
Este es el contraste esencial con el modelo de Cox: allí \(\exp(\beta_k)\) es una razón de riesgos (HR) que multiplica el hazard (la tasa instantánea de riesgo), mientras que aquí \(\exp(\beta_k)\) multiplica el tiempo. Son escalas distintas: AFT actúa sobre el tiempo, Cox actúa sobre el riesgo (2,3).
4.1 Distribución exponencial
La distribución más simple. Asume riesgo constante \(h(t) = \lambda\).
4.1.1 Funciones
\[\begin{aligned} f(t) &= \lambda \exp(-\lambda t) \\ S(t) &= \exp(-\lambda t) \\ h(t) &= \lambda \\ H(t) &= \lambda t \end{aligned}\]
Propiedad clave: No tiene memoria. \(P(T > s + t \mid T > s) = P(T > t)\).
4.1.2 Media y varianza
\[E[T] = \frac{1}{\lambda}, \quad \text{Var}(T) = \frac{1}{\lambda^2}\]
4.1.3 Estimación
El estimador de máxima verosimilitud para \(\lambda\) con censura es:
\[\hat{\lambda} = \frac{\sum_{i=1}^n \delta_i}{\sum_{i=1}^n y_i}\]
donde \(\delta_i\) es el indicador de evento e \(y_i\) el tiempo observado.
# Ajuste exponencial
exp_fit <- survreg(Surv(time, status) ~ x, data = aml, dist = "exponential")
summary(exp_fit)
Call:
survreg(formula = Surv(time, status) ~ x, data = aml, dist = "exponential")
                Value Std. Error     z      p
(Intercept)     4.101      0.378 10.85 <2e-16
xNonmaintained -0.958      0.483 -1.98  0.048

Scale fixed at 1

Exponential distribution
Loglik(model)= -81.3   Loglik(intercept only)= -83.3
    Chisq= 4.06 on 1 degrees of freedom, p= 0.044
Number of Newton-Raphson Iterations: 4
n= 23
# Extraer lambda (riesgo basal, para el grupo de referencia x=0)
lambda_exp <- 1 / exp(coef(exp_fit)[1])
cat("Lambda estimado:", lambda_exp, "\n")Lambda estimado: 0.01654846 cat("Tiempo medio:", 1/lambda_exp, "\n")Tiempo medio: 60.42857 Cómo leer la salida de summary(exp_fit): survreg trabaja en escala log-tiempo, de modo que los Value son coeficientes AFT. El (Intercept) es \(\log\) de la escala del tiempo y, para la exponencial, \(\lambda = 1/\exp(\text{intercept})\) es el riesgo constante. Las columnas z y p testean si cada coeficiente es distinto de cero. Fíjate en que la exponencial no estima Log(scale) (queda fijo), porque asume \(\gamma = 1\). El Tiempo medio impreso es \(1/\lambda\): el tiempo medio esperado hasta el evento bajo riesgo constante.
4.2 Distribución de Weibull
Generalización de la exponencial que permite riesgo creciente, decreciente o constante.
4.2.1 Funciones
\[\begin{aligned} f(t) &= \lambda \gamma t^{\gamma-1} \exp(-\lambda t^\gamma) \\ S(t) &= \exp(-\lambda t^\gamma) \\ h(t) &= \lambda \gamma t^{\gamma-1} \\ H(t) &= \lambda t^\gamma \end{aligned}\]
Parámetros:
- \(\lambda > 0\): parámetro de escala
- \(\gamma > 0\): parámetro de forma
- \(\gamma = 1\): exponencial (riesgo constante)
- \(\gamma < 1\): riesgo decreciente
- \(\gamma > 1\): riesgo creciente
4.2.2 Parametrización alternativa
En R, survreg usa la parametrización:
\[\log T = \mu + \sigma W\]
donde \(W\) sigue una distribución de valor extremo. La relación es:
\[\gamma = \frac{1}{\sigma}, \quad \lambda = \exp(-\mu/\sigma)\]
# Ajuste Weibull
weib_fit <- survreg(Surv(time, status) ~ x, data = aml, dist = "weibull")
summary(weib_fit)
Call:
survreg(formula = Surv(time, status) ~ x, data = aml, dist = "weibull")
                Value Std. Error     z      p
(Intercept)     4.109      0.300 13.70 <2e-16
xNonmaintained -0.929      0.383 -2.43  0.015
Log(scale)     -0.235      0.178 -1.32  0.188

Scale= 0.791

Weibull distribution
Loglik(model)= -80.5   Loglik(intercept only)= -83.2
    Chisq= 5.31 on 1 degrees of freedom, p= 0.021
Number of Newton-Raphson Iterations: 5
n= 23
# Extraer parámetros
gamma_weib <- 1 / weib_fit$scale
lambda_weib <- exp(-coef(weib_fit)[1] / weib_fit$scale)
cat("Gamma (forma):", gamma_weib, "\n")Gamma (forma): 1.264295 cat("Lambda (escala):", lambda_weib, "\n")Lambda (escala): 0.005543889 # Verificación gráfica: log-log plot
# Si Weibull es apropiada, debe ser lineal
km_all <- survfit(Surv(time, status) ~ 1, data = aml)
ok <- km_all$surv > 0 & km_all$surv < 1
plot(log(km_all$time[ok]), log(-log(km_all$surv[ok])),
xlab = "log(tiempo)", ylab = "log(-log(S(t)))",
main = "Diagnóstico Weibull: gráfico log-log")
abline(lm(log(-log(km_all$surv[ok])) ~ log(km_all$time[ok])), col = "red")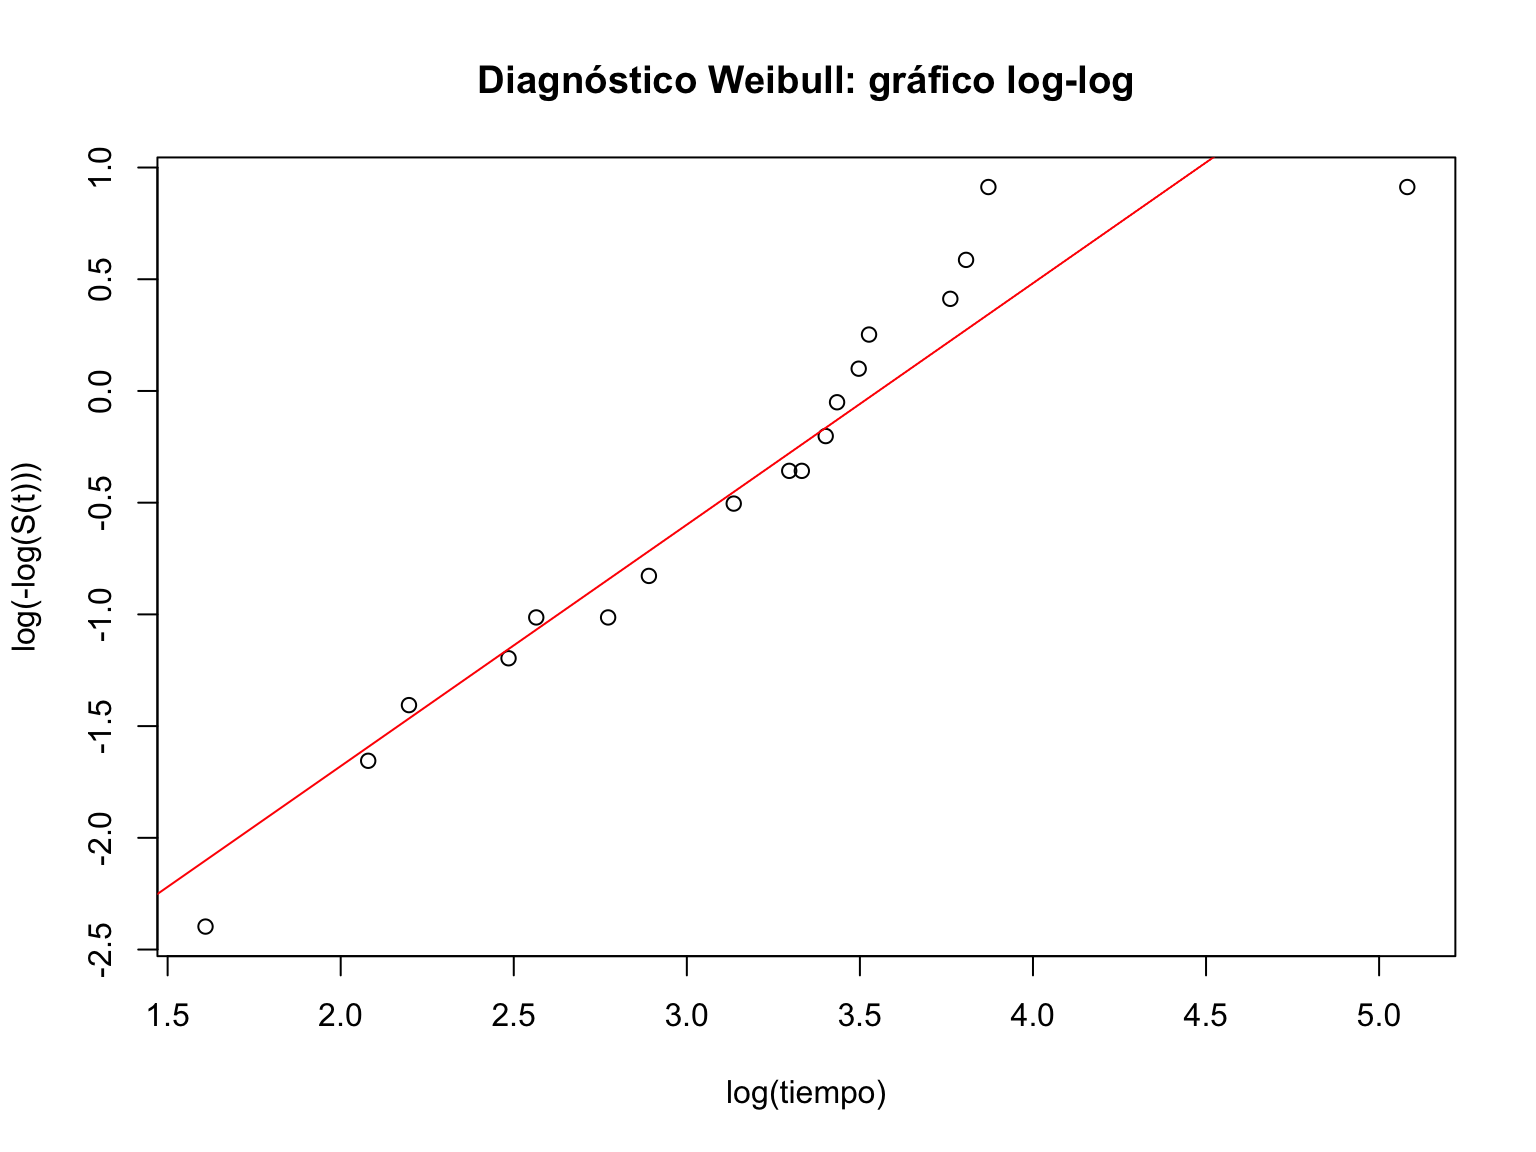
Cómo leer la salida de Weibull: además de los coeficientes AFT (escala log-tiempo), ahora aparece Log(scale) y Scale. El parámetro de forma es \(\gamma = 1/\text{Scale}\) (aquí impreso como Gamma (forma)). Si \(\gamma > 1\) el riesgo crece con el tiempo; si \(\gamma < 1\) decrece; si \(\gamma \approx 1\) la Weibull se reduce a la exponencial. El gráfico log-log de abajo es un diagnóstico: si los puntos se alinean en una recta, la Weibull es razonable; una curvatura clara sugiere probar otras distribuciones.
4.3 Distribución log-normal
Los logaritmos de los tiempos siguen una distribución normal.
4.3.1 Funciones
Si \(\log T \sim N(\mu, \sigma^2)\):
\[\begin{aligned} f(t) &= \frac{1}{t \sigma \sqrt{2\pi}} \exp\left(-\frac{(\log t - \mu)^2}{2\sigma^2}\right) \\ S(t) &= 1 - \Phi\left(\frac{\log t - \mu}{\sigma}\right) \end{aligned}\]
donde \(\Phi\) es la función de distribución acumulada normal estándar.
Característica: La función de riesgo \(h(t)\) primero aumenta y luego disminuye (forma de campana).
# Ajuste log-normal
lognorm_fit <- survreg(Surv(time, status) ~ x, data = aml, dist = "lognormal")
summary(lognorm_fit)
Call:
survreg(formula = Surv(time, status) ~ x, data = aml, dist = "lognormal")
                Value Std. Error     z      p
(Intercept)     3.579      0.285 12.57 <2e-16
xNonmaintained -0.724      0.380 -1.90  0.057
Log(scale)     -0.145      0.170 -0.86  0.391

Scale= 0.865

Log Normal distribution
Loglik(model)= -78.9   Loglik(intercept only)= -80.7
    Chisq= 3.49 on 1 degrees of freedom, p= 0.062
Number of Newton-Raphson Iterations: 4
n= 23
4.4 Distribución log-logística
Similar a log-normal pero con función de supervivencia de forma cerrada.
4.4.1 Funciones
\[\begin{aligned} S(t) &= \frac{1}{1 + \lambda t^\gamma} \\ h(t) &= \frac{\lambda \gamma t^{\gamma-1}}{1 + \lambda t^\gamma} \end{aligned}\]
Característica: También tiene función de riesgo que primero aumenta y luego disminuye cuando \(\gamma > 1\).
# Ajuste log-logístico
loglog_fit <- survreg(Surv(time, status) ~ x, data = aml, dist = "loglogistic")
summary(loglog_fit)
Call:
survreg(formula = Surv(time, status) ~ x, data = aml, dist = "loglogistic")
                Value Std. Error     z      p
(Intercept)     3.503      0.288 12.18 <2e-16
xNonmaintained -0.604      0.393 -1.54 0.1243
Log(scale)     -0.667      0.192 -3.48 0.0005

Scale= 0.513

Log logistic distribution
Loglik(model)= -79.4   Loglik(intercept only)= -80.6
    Chisq= 2.41 on 1 degrees of freedom, p= 0.12
Number of Newton-Raphson Iterations: 3
n= 23
4.5 Comparación de modelos
4.5.1 Criterios de información
AIC (Akaike Information Criterion):
\[\text{AIC} = -2 \log L + 2p\]
BIC (Bayesian Information Criterion):
\[\text{BIC} = -2 \log L + p \log n\]
donde \(L\) es la verosimilitud, \(p\) el número de parámetros y \(n\) el tamaño muestral.
Regla: Menor valor indica mejor ajuste.
# Comparar modelos
modelos <- list(
  Exponencial = exp_fit,
  Weibull = weib_fit,
  LogNormal = lognorm_fit,
  LogLogistic = loglog_fit
)

comparacion <- data.frame(
  Modelo = names(modelos),
  AIC = sapply(modelos, AIC),
  BIC = sapply(modelos, BIC),
  LogLik = sapply(modelos, logLik)
)

kable(comparacion, digits = 2, caption = "Comparación de modelos paramétricos")| Modelo | AIC | BIC | LogLik | |
|---|---|---|---|---|
| Exponencial | Exponencial | 166.57 | 168.85 | -81.29 |
| Weibull | Weibull | 167.04 | 170.45 | -80.52 |
| LogNormal | LogNormal | 163.86 | 167.26 | -78.93 |
| LogLogistic | LogLogistic | 164.71 | 168.11 | -79.35 |
Cómo leer la tabla AIC/BIC: los tres criterios (AIC, BIC y log-verosimilitud) sirven para comparar modelos, anidados o no, pero no son medidas absolutas de bondad. El modelo con menor AIC (y menor BIC) es el que mejor equilibra ajuste y complejidad. BIC penaliza más los parámetros extra, así que tiende a elegir modelos más parsimoniosos. La regla práctica: si dos modelos difieren en AIC en más de 2–4 puntos, la diferencia se considera relevante; diferencias menores son un “empate” y conviene quedarse con el más simple.
4.5.2 Gráfico comparativo
# Grilla de tiempos (en el rango observado)
times_grid <- seq(min(aml$time), max(aml$time), length.out = 100)

# KM de referencia (población completa)
km_ref <- survfit(Surv(time, status) ~ 1, data = aml)

# Reajustamos los modelos paramétricos SIN covariante (población completa),
# para compararlos de forma justa contra el KM global. Usar el intercepto de
# los modelos con `~ x` representaría únicamente el grupo de referencia.
fit_exp  <- survreg(Surv(time, status) ~ 1, data = aml, dist = "exponential")
fit_weib <- survreg(Surv(time, status) ~ 1, data = aml, dist = "weibull")
fit_ln   <- survreg(Surv(time, status) ~ 1, data = aml, dist = "lognormal")
fit_ll   <- survreg(Surv(time, status) ~ 1, data = aml, dist = "loglogistic")

# Exponencial: S(t) = exp(-lambda * t)
l_exp  <- 1 / exp(coef(fit_exp)[1])
S_exp  <- exp(-l_exp * times_grid)

# Weibull: S(t) = exp(-lambda * t^gamma)
g_w   <- 1 / fit_weib$scale
l_w   <- exp(-coef(fit_weib)[1] / fit_weib$scale)
S_weib <- exp(-l_w * times_grid^g_w)

# Log-normal: S(t) = 1 - Phi((log t - mu)/sigma)
mu_ln  <- coef(fit_ln)[1]
sig_ln <- fit_ln$scale
S_logn <- 1 - pnorm((log(times_grid) - mu_ln) / sig_ln)

# Log-logística: S(t) = 1 / (1 + lambda * t^gamma)
mu_ll  <- coef(fit_ll)[1]
sig_ll <- fit_ll$scale
g_ll   <- 1 / sig_ll
l_ll   <- exp(-mu_ll / sig_ll)
S_logl <- 1 / (1 + l_ll * times_grid^g_ll)

# Curvas
plot(km_ref, conf.int = FALSE, xlab = "Tiempo", ylab = "S(t)",
     main = "Comparación de modelos", xlim = range(times_grid))
lines(times_grid, S_exp,  col = "red",    lwd = 2)
lines(times_grid, S_weib, col = "blue",   lwd = 2)
lines(times_grid, S_logn, col = "green",  lwd = 2)
lines(times_grid, S_logl, col = "purple", lwd = 2)

legend("topright",
       legend = c("Kaplan-Meier", "Exponencial", "Weibull", "Log-normal", "Log-logística"),
       col = c("black", "red", "blue", "green", "purple"),
       lty = 1,
       lwd = c(1, 2, 2, 2, 2))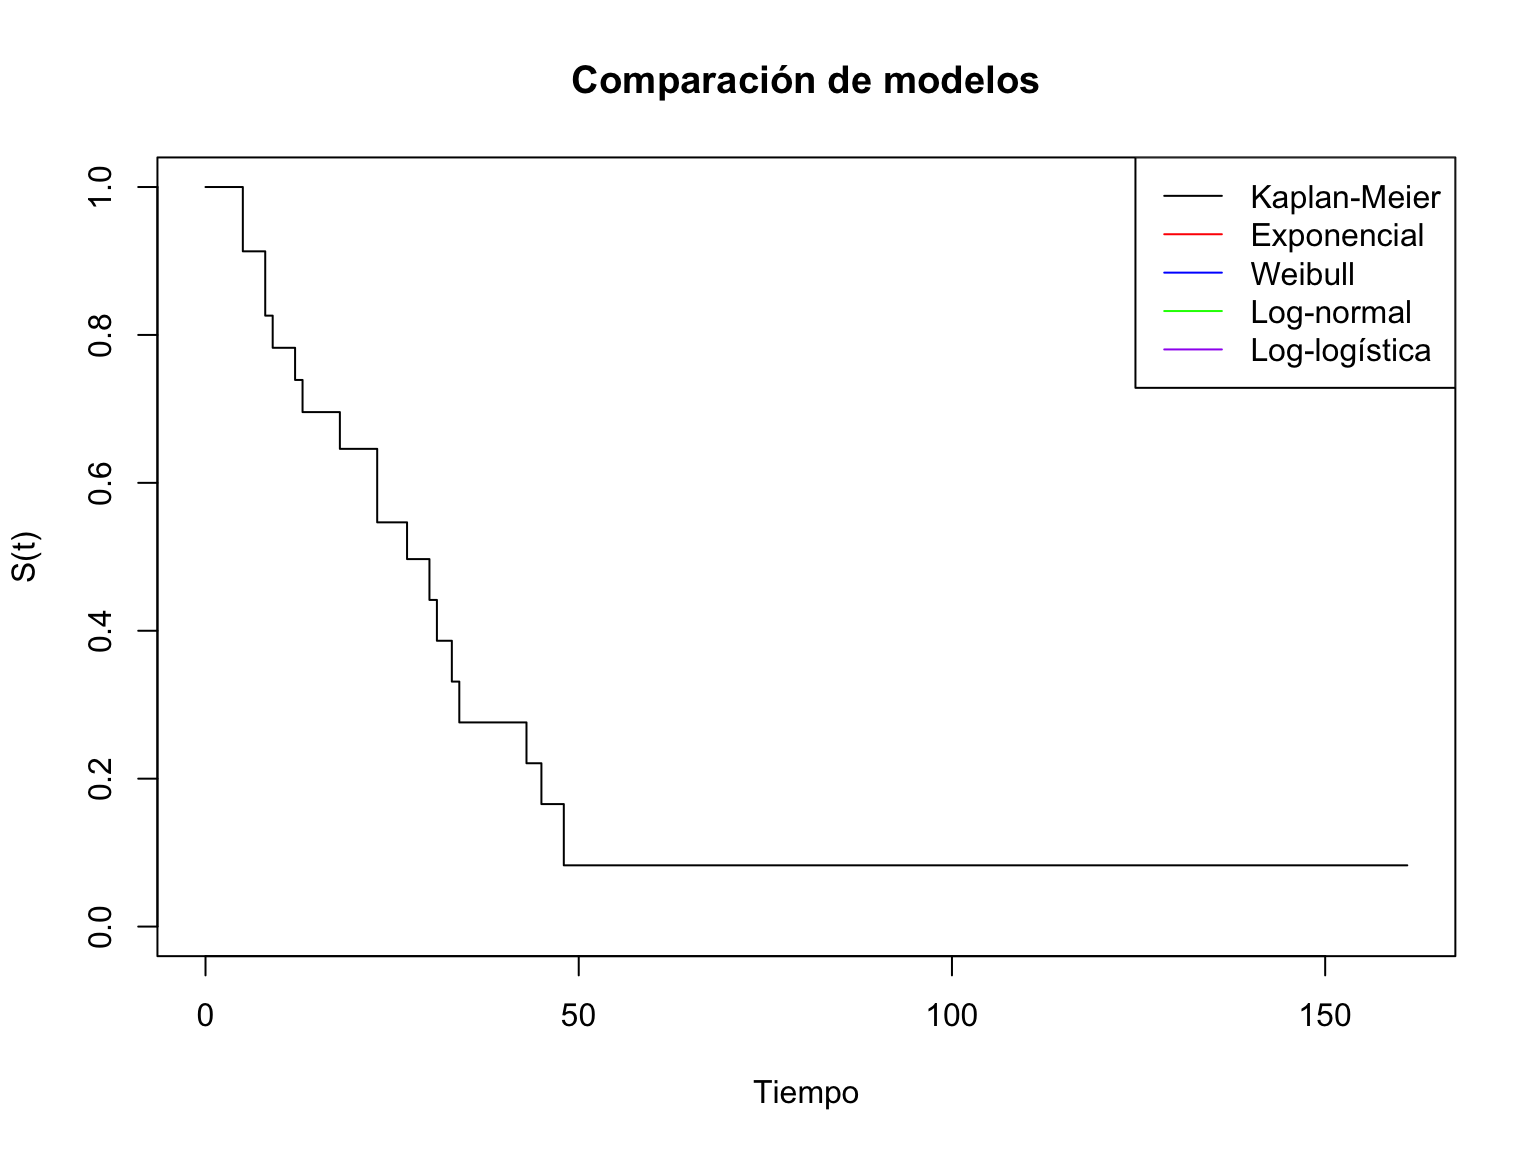
5 Modelo de riesgos proporcionales de Cox
El modelo de Cox (12) es el modelo semiparamétrico más utilizado en análisis de supervivencia.
Idea útil: Cox intenta explicar por qué unos sujetos “llegan antes al evento” que otros, pero sin imponer una forma paramétrica completa para el hazard basal. En lugar de eso, modela cómo cambian los riesgos relativos con covariables (vía HR), dejando que la forma exacta del riesgo a lo largo del tiempo quede “flexible” en el componente basal.
5.1 Especificación del modelo
El modelo asume que la función de riesgo para el individuo \(i\) es:
\[h_i(t \mid \mathbf{X}_i) = h_0(t) \exp(\boldsymbol{\beta}' \mathbf{X}_i)\]
donde:
- \(h_0(t)\) es la función de riesgo basal (no especificada)
- \(\mathbf{X}_i = (X_{i1}, \ldots, X_{ip})'\) es el vector de covariables
- \(\boldsymbol{\beta} = (\beta_1, \ldots, \beta_p)'\) es el vector de coeficientes
5.1.1 Razón de riesgos (Hazard Ratio)
Comparando dos individuos con covariables \(\mathbf{X}_i\) y \(\mathbf{X}_j\):
\[\text{HR}_{ij}(t) = \frac{h_i(t \mid \mathbf{X}_i)}{h_j(t \mid \mathbf{X}_j)} = \frac{h_0(t) \exp(\boldsymbol{\beta}' \mathbf{X}_i)}{h_0(t) \exp(\boldsymbol{\beta}' \mathbf{X}_j)} = \exp[\boldsymbol{\beta}'(\mathbf{X}_i - \mathbf{X}_j)]\]
Propiedad clave: La razón de riesgos es constante en el tiempo (asunción de riesgos proporcionales).
5.1.2 Interpretación de coeficientes
Para una covariable continua \(X_k\):
\[\text{HR} = \exp(\beta_k)\]
Interpretación práctica: \(\exp(\beta_k)\) compara el riesgo instantáneo (hazard) entre dos individuos que difieren en una unidad de \(X_k\), manteniendo constantes las demás covariables.
- \(\beta_k > 0\) (\(\text{HR} > 1\)): el hazard aumenta; en el lenguaje cotidiano, “si sube \(X_k\), el evento tiende a ocurrir antes”.
- \(\beta_k < 0\) (\(\text{HR} < 1\)): el hazard disminuye; “si sube \(X_k\), el evento tiende a ocurrir más tarde”.
- \(\beta_k = 0\) (\(\text{HR} = 1\)): no hay evidencia de efecto (en el modelo ajustado).
Ejemplo: si \(\beta_1 = 0.5\), entonces \(\text{HR} = \exp(0.5) \approx 1.65\), indicando que el hazard instantáneo es aproximadamente 1.65 veces mayor por cada unidad adicional en \(X_1\) (manteniendo el resto igual). Ojo: esto es “en el instante”, no una probabilidad final acumulada.
Consejo de rigor: si el modelo falla en la asunción de riesgos proporcionales (por ejemplo, por no linealidades o efectos que cambian con el tiempo), la interpretación “HR constante” deja de ser fiable y conviene revisar diagnósticos (Schoenfeld, gráficos log-log, términos dependientes del tiempo o estratificación).
5.2 Verosimilitud parcial
La estimación de \(\boldsymbol{\beta}\) se realiza mediante verosimilitud parcial (13):
\[L(\boldsymbol{\beta}) = \prod_{i: \delta_i = 1} \frac{\exp(\boldsymbol{\beta}' \mathbf{X}_i)}{\sum_{j \in R(t_i)} \exp(\boldsymbol{\beta}' \mathbf{X}_j)}\]
donde \(R(t_i)\) es el conjunto de riesgo en el tiempo \(t_i\) (individuos que no han experimentado el evento ni han sido censurados antes de \(t_i\)).
Estimación de la función de riesgo basal: una vez estimados los coeficientes \(\hat{\boldsymbol{\beta}}\), la función de riesgo acumulada basal se estima mediante el estimador de Breslow (11),
\[\hat{H}_0(t) = \sum_{j: t_j \leq t} \frac{d_j}{\sum_{\ell \in R(t_j)} \exp(\hat{\boldsymbol{\beta}}' \mathbf{X}_\ell)},\]
que generaliza el estimador de Nelson-Aalen al caso con covariables. A partir de él se obtiene la supervivencia basal \(\hat{S}_0(t) = \exp(-\hat{H}_0(t))\) y la supervivencia individual \(\hat{S}(t \mid \mathbf{X}) = \hat{S}_0(t)^{\exp(\hat{\boldsymbol{\beta}}' \mathbf{X})}\).
Empates (ties): cuando varios individuos experimentan el evento exactamente en el mismo tiempo, la verosimilitud parcial exacta requiere enumerar todos los ordenamientos posibles, lo que es computacionalmente costoso. En la práctica se usan aproximaciones: Breslow (la más simple, ligeramente sesgada con muchos empates) y Efron (más precisa y la opción por defecto en coxph() de R) (1,14).
5.3 Ejemplo: datos de cáncer de pulmón
# Datos
data(lung, package = "survival")
lung <- na.omit(lung)

# Ajuste del modelo
cox_fit <- coxph(Surv(time, status) ~ age + sex + ph.ecog + ph.karno +
                   pat.karno + meal.cal + wt.loss,
                 data = lung)

summary(cox_fit)
Call:
coxph(formula = Surv(time, status) ~ age + sex + ph.ecog + ph.karno +
pat.karno + meal.cal + wt.loss, data = lung)
n= 167, number of events= 120
coef exp(coef) se(coef) z Pr(>|z|)
age 1.080e-02 1.011e+00 1.160e-02 0.931 0.35168
sex -5.536e-01 5.749e-01 2.016e-01 -2.746 0.00603 **
ph.ecog 7.395e-01 2.095e+00 2.250e-01 3.287 0.00101 **
ph.karno 2.244e-02 1.023e+00 1.123e-02 1.998 0.04575 *
pat.karno -1.207e-02 9.880e-01 8.116e-03 -1.488 0.13685
meal.cal 2.835e-05 1.000e+00 2.594e-04 0.109 0.91298
wt.loss -1.420e-02 9.859e-01 7.766e-03 -1.828 0.06748 .
---
Signif. codes: 0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
exp(coef) exp(-coef) lower .95 upper .95
age 1.0109 0.9893 0.9881 1.0341
sex 0.5749 1.7395 0.3872 0.8534
ph.ecog 2.0950 0.4773 1.3479 3.2560
ph.karno 1.0227 0.9778 1.0004 1.0455
pat.karno 0.9880 1.0121 0.9724 1.0038
meal.cal 1.0000 1.0000 0.9995 1.0005
wt.loss 0.9859 1.0143 0.9710 1.0010
Concordance= 0.653 (se = 0.029 )
Likelihood ratio test= 28.16 on 7 df, p=2e-04
Wald test = 27.5 on 7 df, p=3e-04
Score (logrank) test = 28.31 on 7 df, p=2e-04Cómo leer summary(cox_fit): la tabla principal tiene coef (el log-HR), exp(coef) (el HR), se(coef), z y Pr(>|z|) (p-valor del test de Wald). Interpreta cada fila así: exp(coef) > 1 sube el riesgo, < 1 lo baja; un p-valor pequeño indica evidencia contra “sin efecto”. Debajo, Concordance es el C-index (≈ 0.65 aquí), y las tres líneas de test (razón de verosimilitud, Wald y score/log-rank) contrastan globalmente que todos los coeficientes sean cero. Al final, n y number of events recuerdan que la potencia depende de los eventos observados, no solo del tamaño muestral.
5.3.1 Intervalos de confianza
Intervalos de confianza al 95% para HR:
# IC para HR
exp(confint(cox_fit))
2.5 % 97.5 %
age 0.9881389 1.0341075
sex 0.3872369 0.8534079
ph.ecog 1.3479247 3.2559956
ph.karno 1.0004241 1.0454545
pat.karno 0.9724065 1.0038410
meal.cal 0.9995201 1.0005369
wt.loss 0.9710067 1.0010219Cómo leer esta salida: un intervalo de confianza (IC) al 95% para una HR concreta cuantifica la incertidumbre. La regla práctica más usada es:
- si el IC no incluye 1, hay evidencia (al 5%) de que el efecto no es nulo,
- si el IC incluye 1, la información disponible no permite descartar un efecto nulo con ese nivel de evidencia.
5.4 Estratificación
Cuando la asunción de riesgos proporcionales no se cumple para una covariable, se puede estratificar por ella:
\[h_{ij}(t \mid \mathbf{X}_{ij}) = h_{0j}(t) \exp(\boldsymbol{\beta}' \mathbf{X}_{ij})\]
donde \(j\) indexa el estrato.
# Modelo estratificado por sexo
cox_strat <- coxph(Surv(time, status) ~ age + strata(sex) + ph.ecog,
                   data = lung)
summary(cox_strat)
Call:
coxph(formula = Surv(time, status) ~ age + strata(sex) + ph.ecog,
data = lung)
n= 167, number of events= 120
coef exp(coef) se(coef) z Pr(>|z|)
age 0.007446 1.007474 0.011088 0.671 0.501902
ph.ecog 0.458227 1.581268 0.138465 3.309 0.000935 ***
---
Signif. codes: 0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
exp(coef) exp(-coef) lower .95 upper .95
age 1.007 0.9926 0.9858 1.030
ph.ecog 1.581 0.6324 1.2054 2.074
Concordance= 0.619 (se = 0.031 )
Likelihood ratio test= 13.45 on 2 df, p=0.001
Wald test = 13.51 on 2 df, p=0.001
Score (logrank) test = 13.73 on 2 df, p=0.001Cómo leer el modelo estratificado: al usar strata(sex), R ya no estima un HR para el sexo (esa covariable “desaparece” de la tabla), porque cada sexo tiene su propia función de riesgo basal \(h_{0j}(t)\). Esto es lo correcto cuando el sexo viola riesgos proporcionales: así no forzamos un HR constante que no existe, a costa de no poder resumir el efecto del sexo en una sola cifra.
5.5 Diagnóstico del modelo
5.5.1 Verificación de riesgos proporcionales
5.5.1.1 Test de Schoenfeld
Los residuos de Schoenfeld (15) permiten verificar la asunción de riesgos proporcionales. Para cada covariable \(k\), se define un residuo en cada tiempo de evento \(t_i\):
\[r_{ik} = \delta_i \left[X_{ik} - \frac{\sum_{j \in R(t_i)} X_{jk} \exp(\boldsymbol{\beta}' \mathbf{X}_j)}{\sum_{j \in R(t_i)} \exp(\boldsymbol{\beta}' \mathbf{X}_j)}\right]\]
El término entre corchetes es la diferencia entre el valor observado \(X_{ik}\) y la media ponderada de \(X_k\) entre los individuos aún en riesgo en \(t_i\); por tanto, el residuo mide cuánto se desvía una covariable de lo que “se esperaría” si el riesgo fuera proporcional. Si la asunción se cumple, los residuos escalados deben ser independientes del tiempo, es decir, su gráfico contra \(t\) debe tener pendiente cero (en la práctica, una banda de suavizado localmente horizontal). La función cox.zph() contrasta formalmente esta hipótesis para cada covariable y globalmente (14).
# Test de riesgos proporcionales
test_ph <- cox.zph(cox_fit)
print(test_ph)
chisq df p
age 0.0581 1 0.810
sex 1.3567 1 0.244
ph.ecog 3.1105 1 0.078
ph.karno 5.9656 1 0.015
pat.karno 3.2117 1 0.073
meal.cal 6.5599 1 0.010
wt.loss 0.0833 1 0.773
GLOBAL 13.8427 7 0.054# Gráfico
par(mfrow = c(2, 2))
plot(test_ph)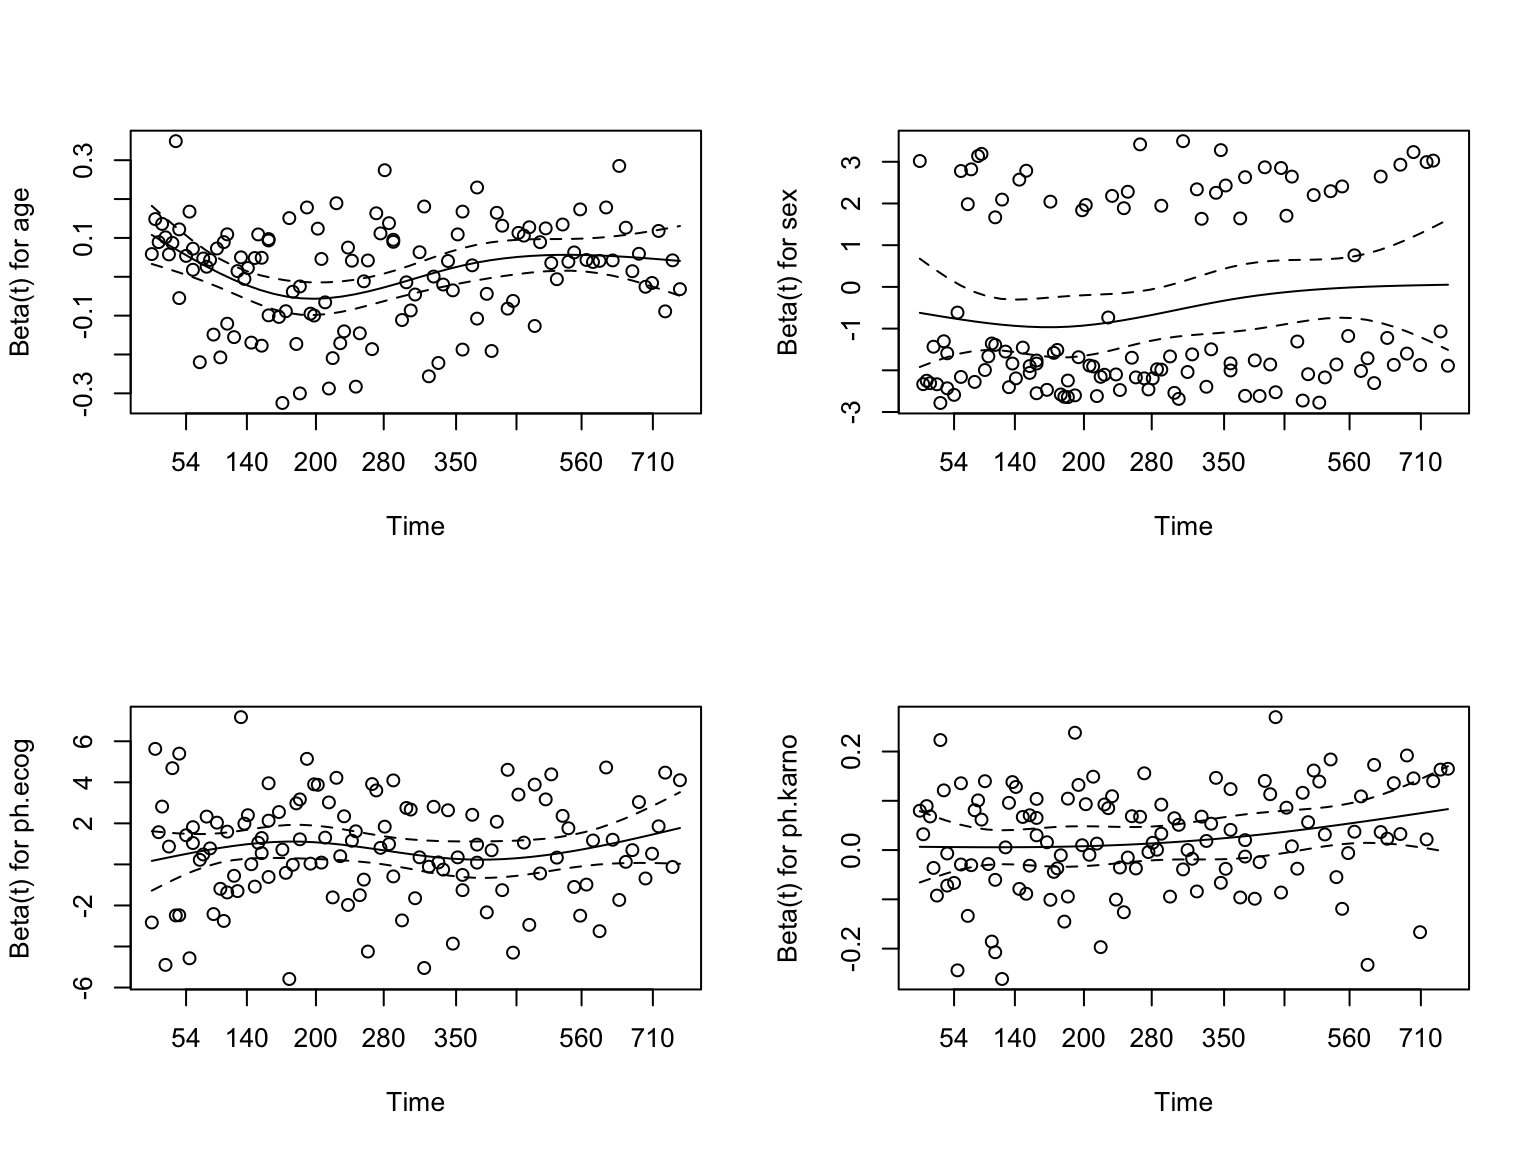
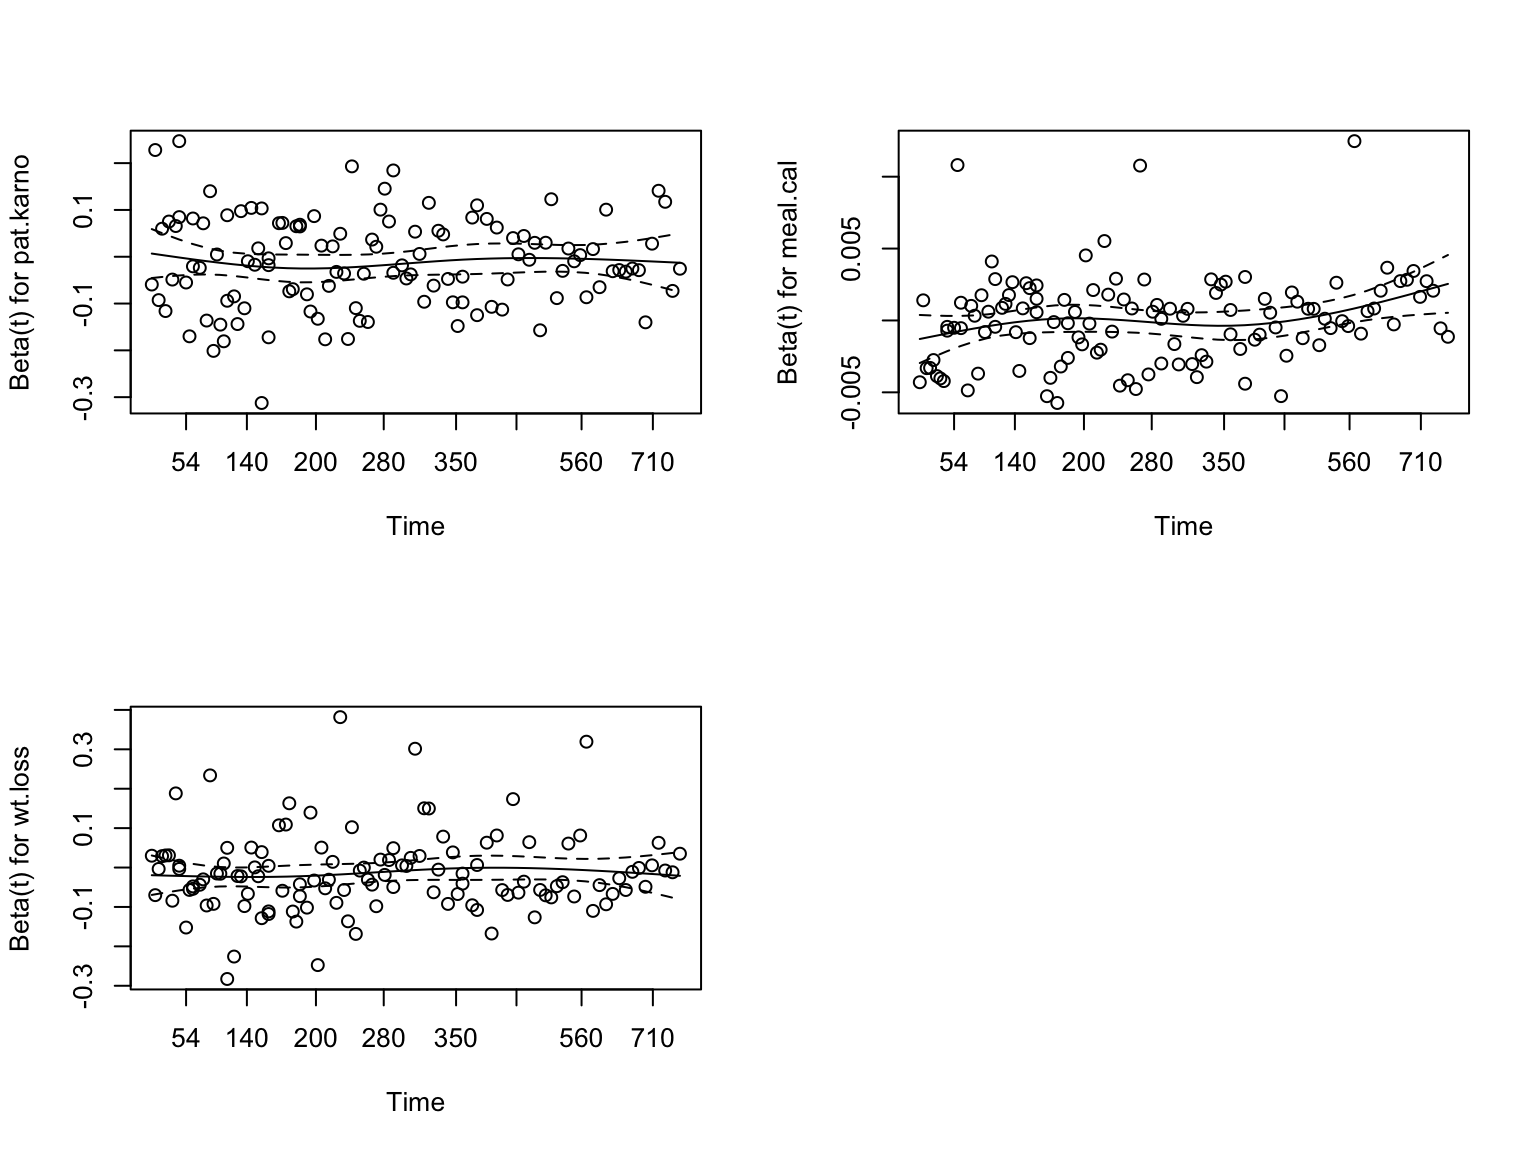
Interpretación: Un p-valor < 0.05 sugiere violación de la asunción de riesgos proporcionales.
Lectura humana: esto significa que la “multiplicación del riesgo” asociada a esa covariable probablemente cambia con el tiempo. En ese caso, la interpretación simple de HR constante deja de ser defendible y conviene explorar soluciones como:
- usar una covariable dependiente del tiempo,
- estratificar,
- o introducir no linealidades/splines,
- o considerar modelos alternativos.
5.5.1.2 Gráficos log-log
Para covariables categóricas:
km_sex <- survfit(Surv(time, status) ~ sex, data = lung)
plot(km_sex, fun = "cloglog",
     xlab = "log(Tiempo)", ylab = "log(-log(S(t)))",
     main = "Verificación de riesgos proporcionales")
legend("topleft", legend = c("Hombre", "Mujer"), col = 1:2, lty = 1)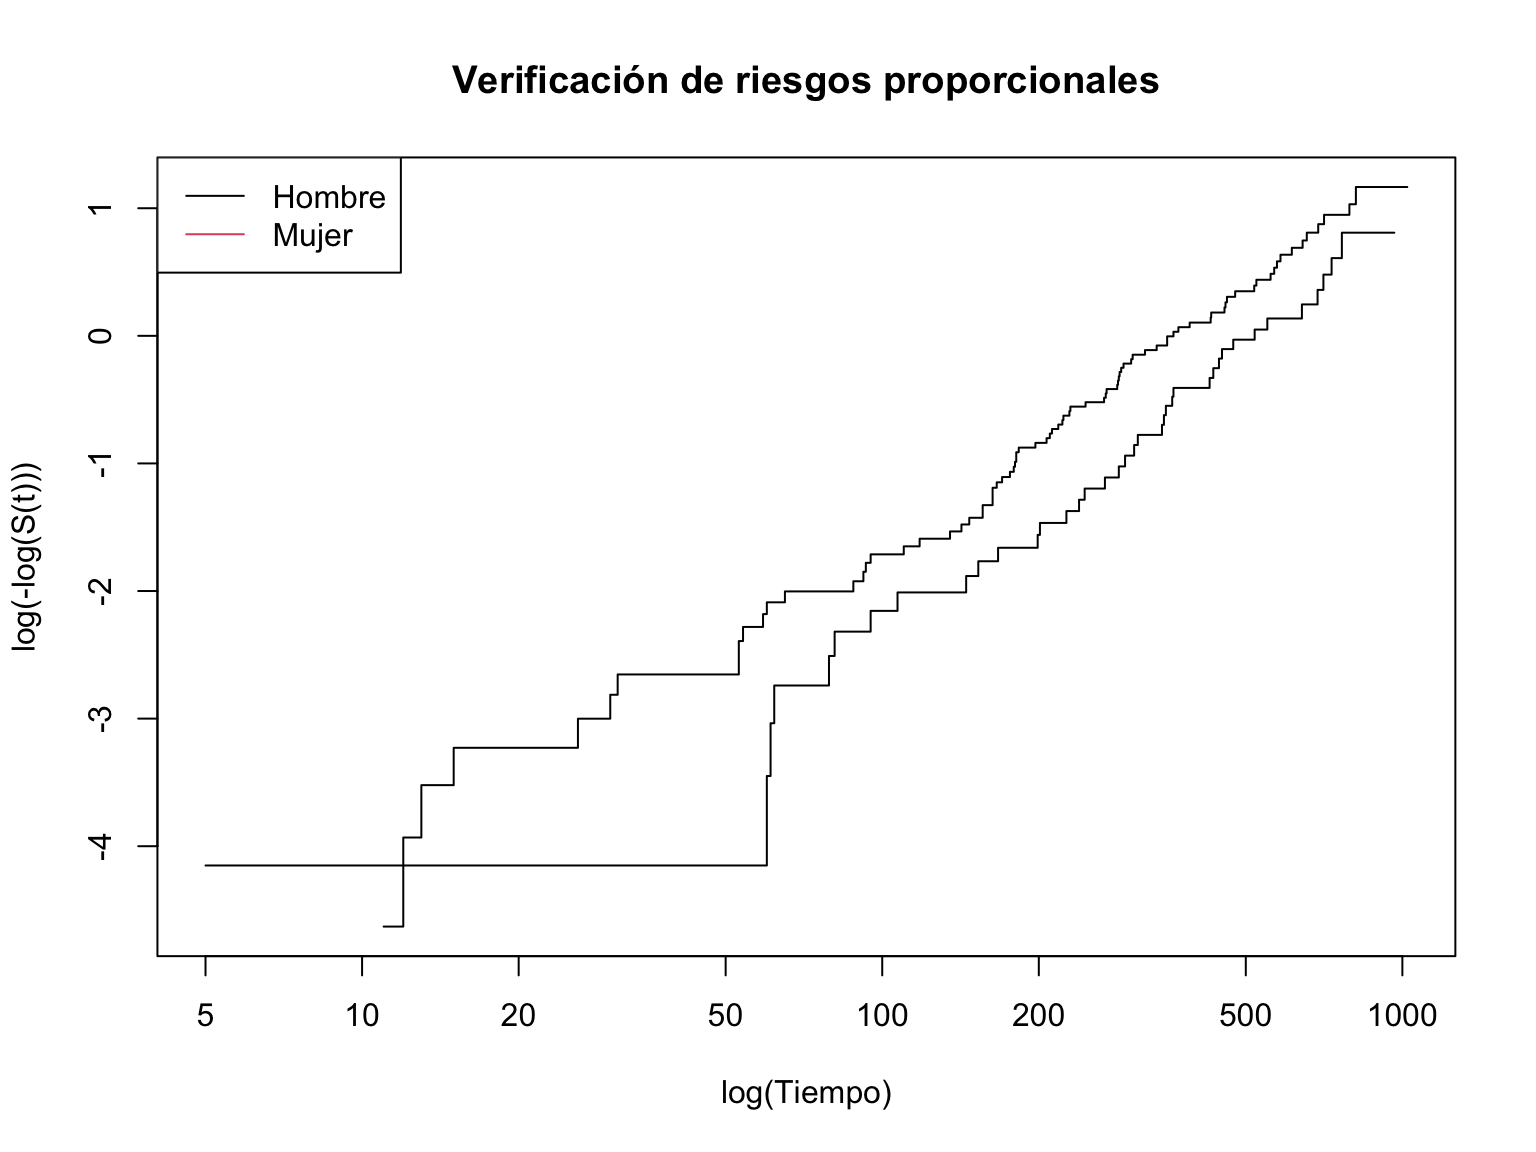
Si las líneas son paralelas, la asunción se cumple.
5.5.2 Residuos de martingale
Los residuos de martingale detectan la forma funcional de covariables continuas:
\[M_i = \delta_i - \hat{H}_0(t_i) \exp(\boldsymbol{\beta}' \mathbf{X}_i)\]
es decir, el número de eventos observados (\(\delta_i\), 0 o 1) menos el número de eventos esperados bajo el modelo. Toman valores en \((-\infty, 1]\), con media cero y están correlacionados entre sí. Su utilidad principal es diagnosticar la forma funcional de covariables continuas: al representarlos frente a la covariable \(X_k\), la desviación sistemática de la horizontal indica que \(X_k\) no entra linealmente en el modelo (p. ej., requiere una transformación o un spline). Estos residuos surgen de la formulación del modelo de Cox como proceso de conteo mediante la teoría de martingalas (14,16).
mart_res <- residuals(cox_fit, type = "martingale")

plot(lung$age, mart_res,
     xlab = "Edad", ylab = "Residuos de martingale",
     main = "Verificación de forma funcional")
lines(lowess(lung$age, mart_res), col = "red", lwd = 2)
abline(h = 0, lty = 2)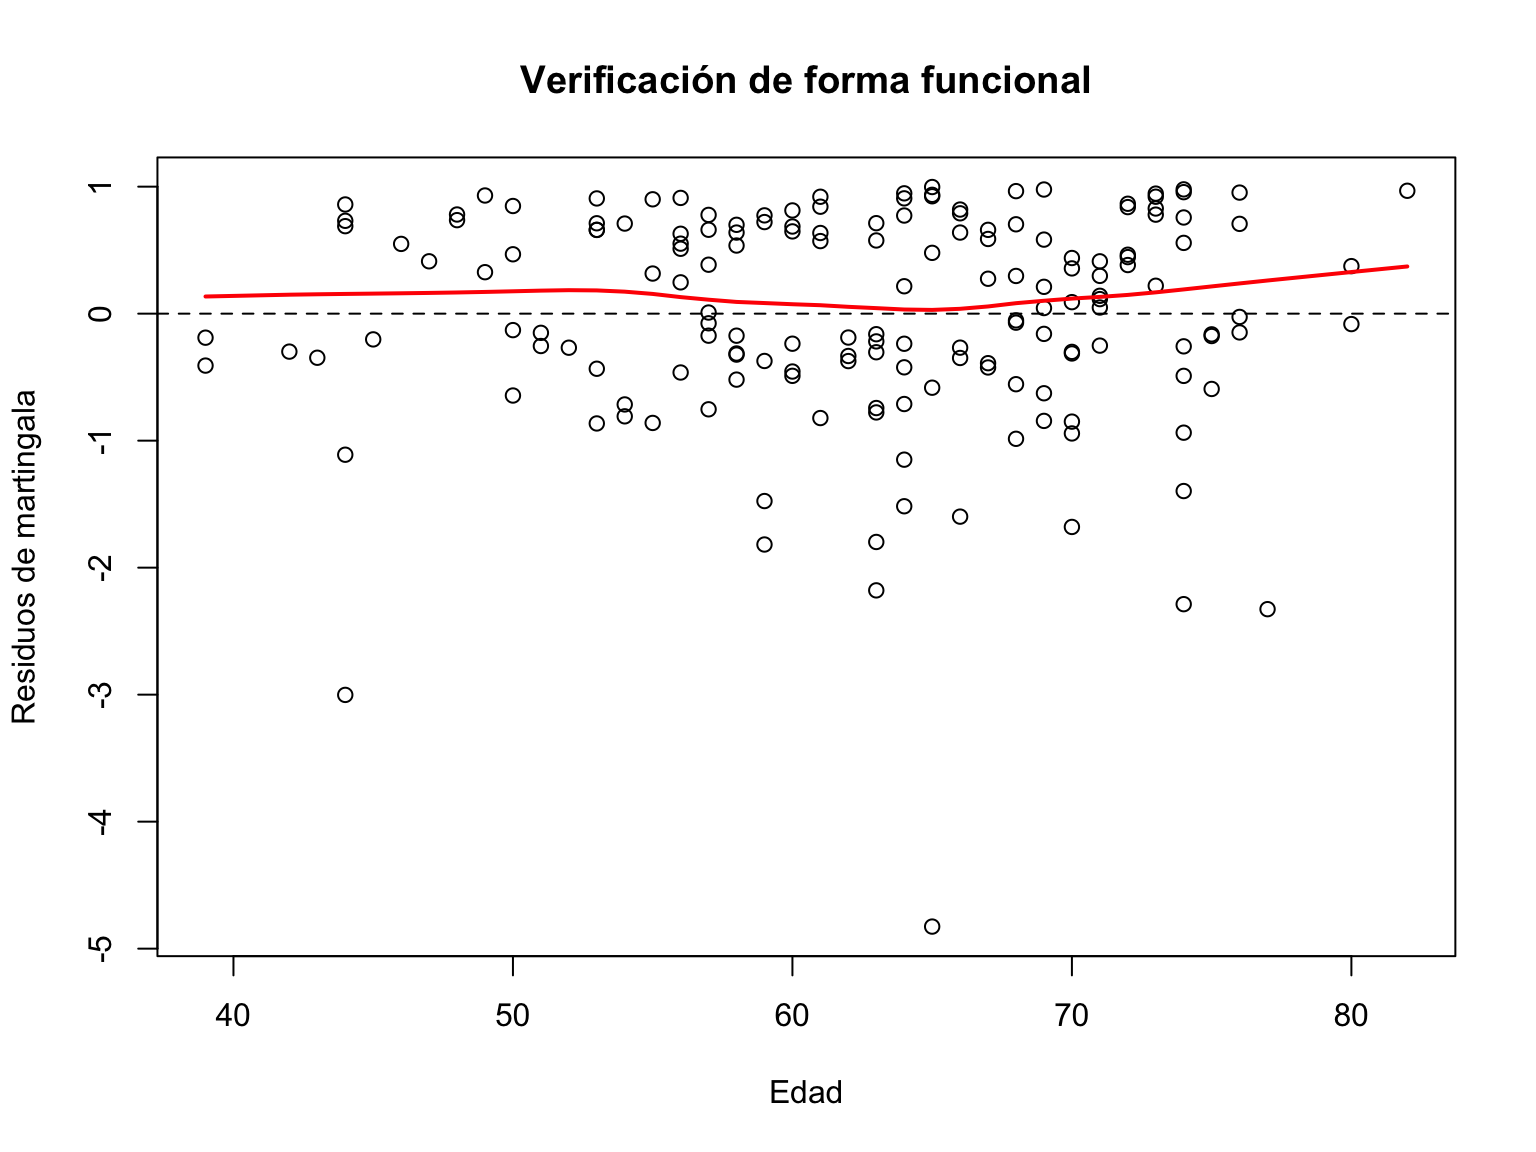
5.5.3 Residuos de deviance
Los residuos de deviance son transformaciones simétricas de los residuos de martingale (la idea es “hacerlos comparables” en magnitud y mejorar la inspección visual). Su objetivo práctico es ayudar a detectar observaciones influyentes o patrones de mala adecuación del modelo: valores alejados de 0 suelen indicar que ese sujeto contribuye de forma inusual a la discrepancia entre observado y esperado.
\[D_i = \text{sign}(M_i) \sqrt{-2[M_i + \delta_i \log(\delta_i - M_i)]}\]
Útiles para detectar observaciones atípicas. Cómo leer la figura: si los residuos de deviance muestran valores muy alejados de 0 (especialmente con signo consistente), suele indicar que ese individuo o subgrupo no está bien representado por la forma funcional y covariables asumidas en el modelo.
dev_res <- residuals(cox_fit, type = "deviance")

plot(dev_res,
     xlab = "Índice", ylab = "Residuos de deviance",
     main = "Detección de observaciones atípicas")
abline(h = c(-2, 0, 2), lty = c(2, 1, 2))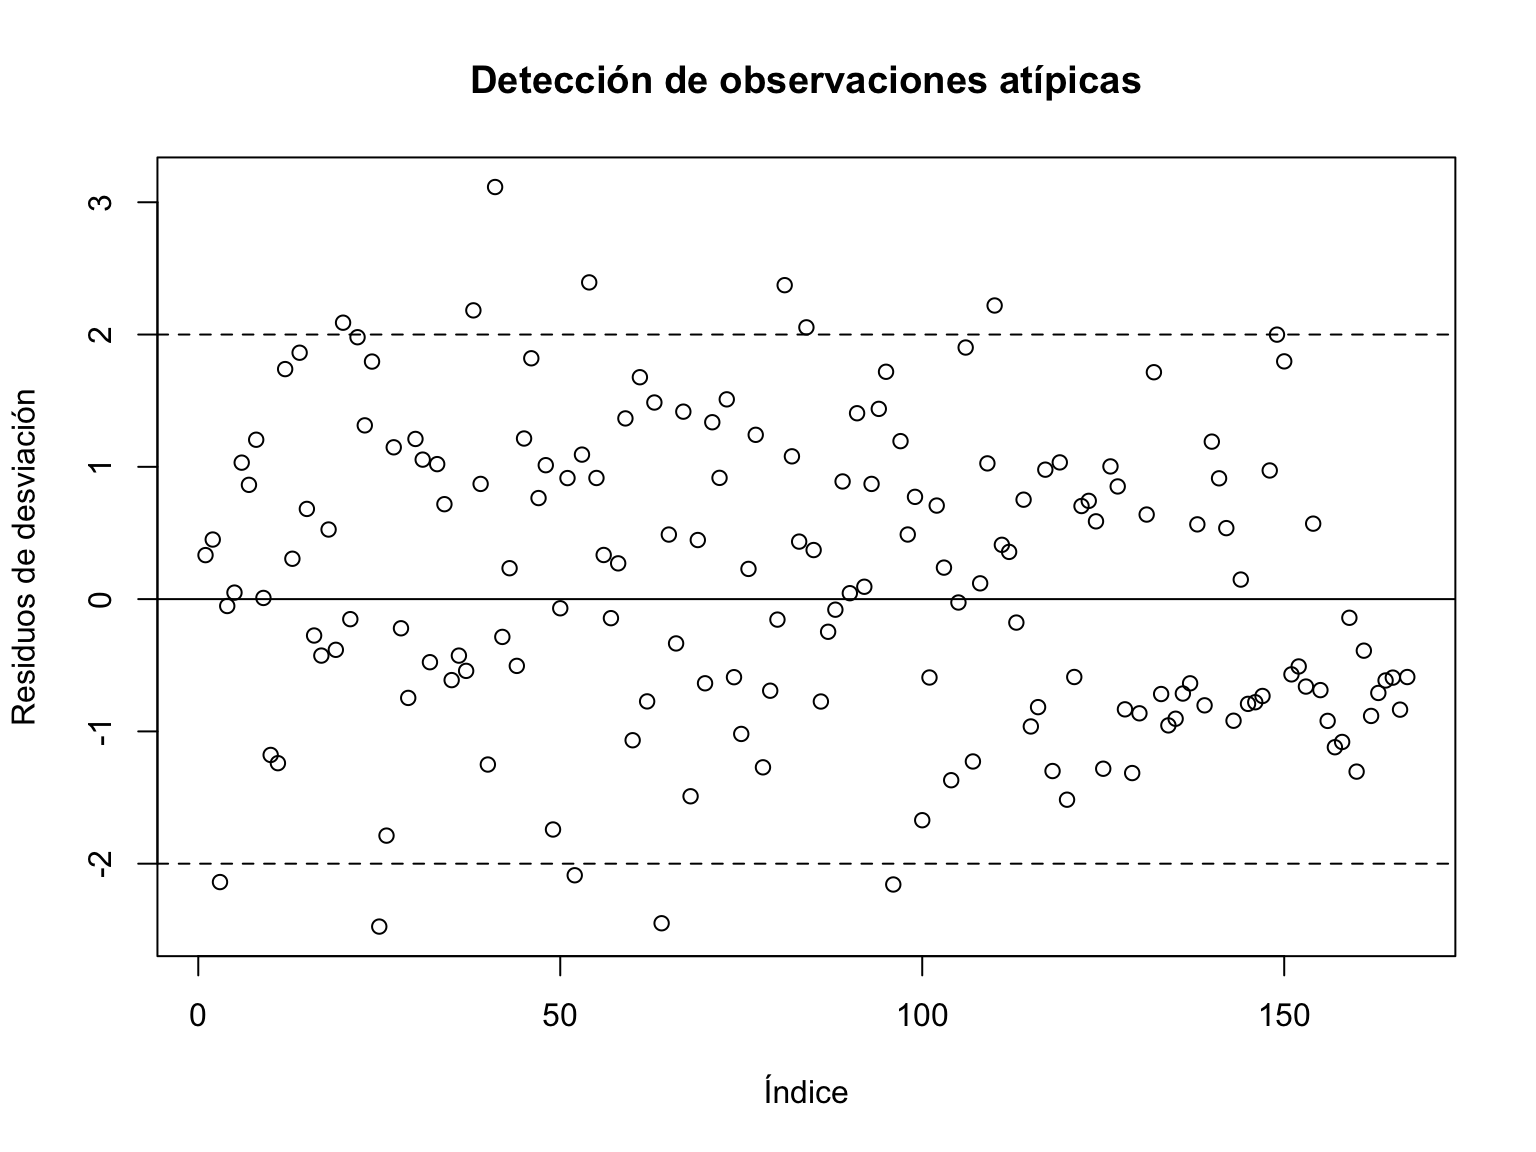
5.5.4 Estadísticos de influencia
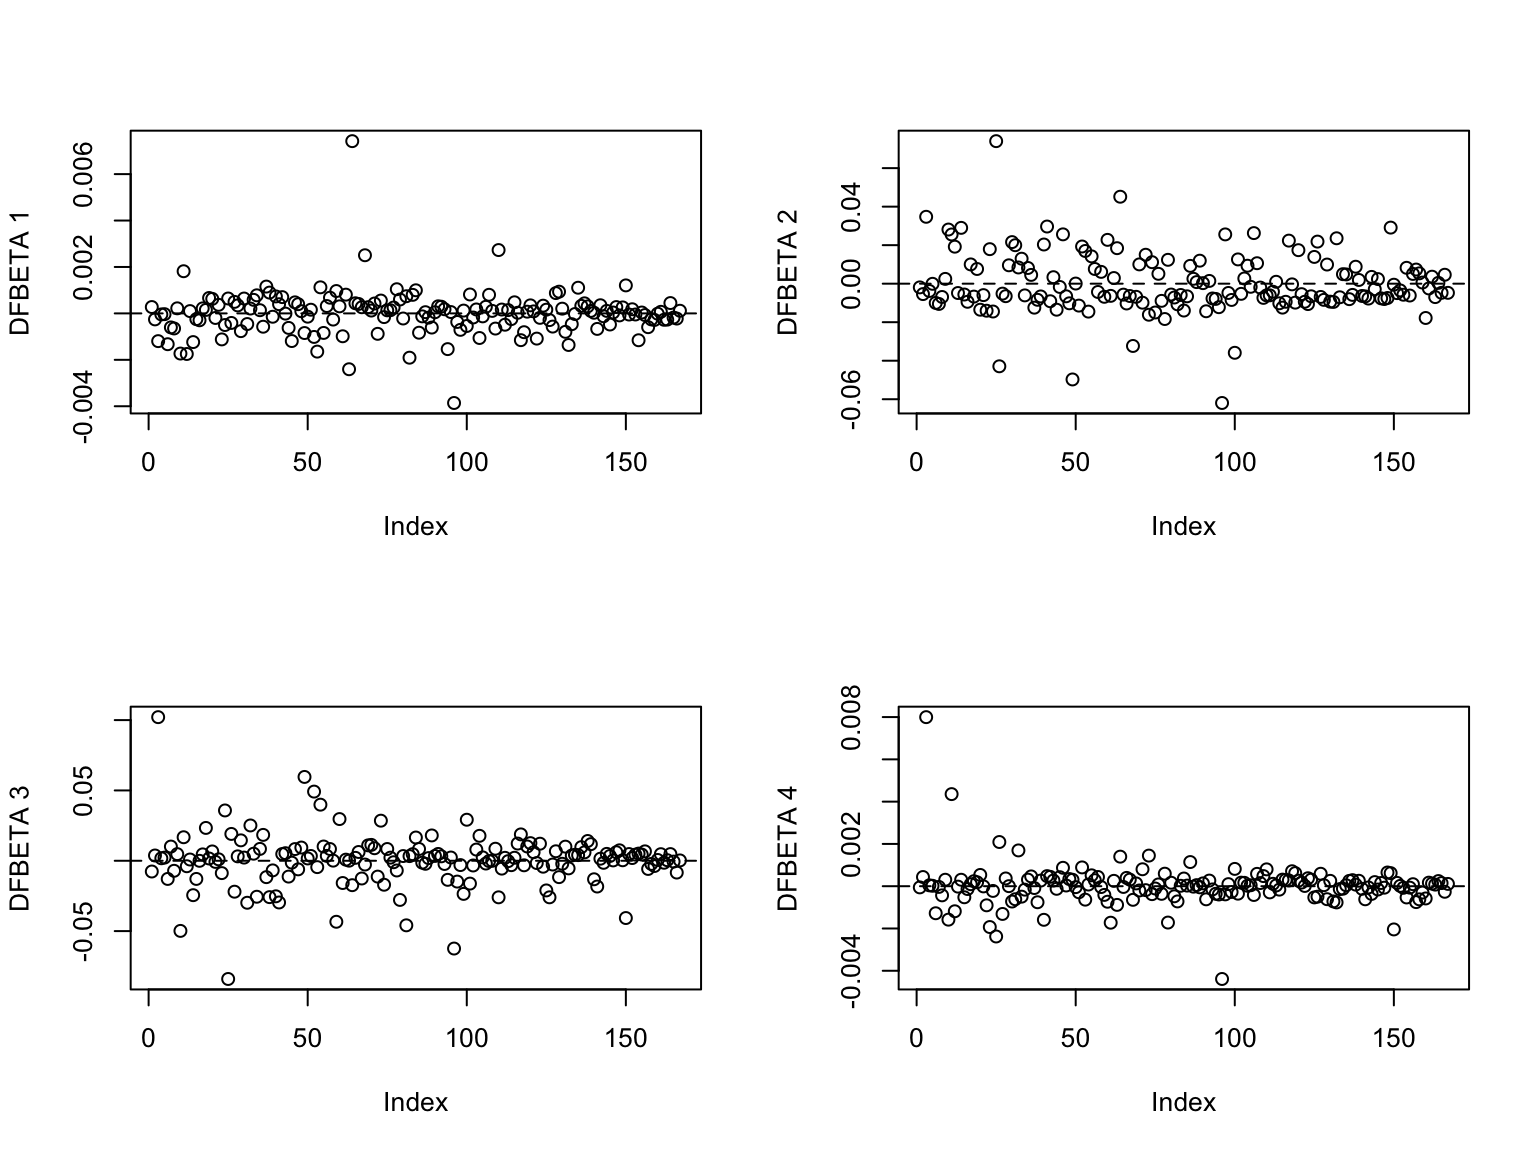
DFBETAs: miden el cambio en \(\hat{\boldsymbol{\beta}}\) al eliminar la observación \(i\).
Interpretación de salida: en el gráfico, busca puntos con magnitud muy superior al resto. Si al quitar un sujeto (en el modelo ajustado) se mueven apreciablemente algunos coeficientes, ese sujeto es influyente: no necesariamente significa “malo”, pero sí que el resultado del modelo puede depender de información muy particular contenida en esas observaciones.
dfb <- residuals(cox_fit, type = "dfbeta")

par(mfrow = c(2, 2))
for (j in 1:min(4, ncol(dfb))) {
  plot(dfb[, j], ylab = paste("DFBETA", j),
       main = colnames(dfb)[j])
  abline(h = 0, lty = 2)
}
5.6 Extensiones del modelo de Cox
5.6.1 Covariables dependientes del tiempo
Permite que las covariables cambien con el tiempo:
\[h_i(t \mid \mathbf{X}_i(t)) = h_0(t) \exp(\boldsymbol{\beta}' \mathbf{X}_i(t))\]
# Ejemplo: efecto de tratamiento que cambia después de 6 meses
lung$trt_after6 <- lung$time > 180

# Formato tstart-tstop para covariables dependientes del tiempo
lung_td <- survSplit(Surv(time, status) ~ .,
                     data = lung,
                     cut = 180,
                     episode = "interval")

# Modelo
cox_td <- coxph(Surv(tstart, time, status) ~ age + sex + interval,
                data = lung_td)
summary(cox_td)
Call:
coxph(formula = Surv(tstart, time, status) ~ age + sex + interval,
data = lung_td)
n= 287, number of events= 120
coef exp(coef) se(coef) z Pr(>|z|)
age 0.01737 1.01752 0.01084 1.603 0.1089
sex -0.44669 0.63974 0.19754 -2.261 0.0237 *
interval NA NA 0.00000 NA NA
---
Signif. codes: 0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
exp(coef) exp(-coef) lower .95 upper .95
age 1.0175 0.9828 0.9961 1.0394
sex 0.6397 1.5631 0.4344 0.9422
interval NA NA NA NA
Concordance= 0.601 (se = 0.032 )
Likelihood ratio test= 8.88 on 2 df, p=0.01
Wald test = 8.47 on 2 df, p=0.01
Score (logrank) test = 8.6 on 2 df, p=0.015.6.2 Términos de interacción
Permiten que el efecto de una covariable dependa de otra:
# Interacción entre edad y sexo
cox_int <- coxph(Surv(time, status) ~ age * sex + ph.ecog, data = lung)
summary(cox_int)
Call:
coxph(formula = Surv(time, status) ~ age * sex + ph.ecog, data = lung)
n= 167, number of events= 120
coef exp(coef) se(coef) z Pr(>|z|)
age 0.04141 1.04228 0.03245 1.276 0.201924
sex 1.03506 2.81528 1.39970 0.739 0.459611
ph.ecog 0.48187 1.61909 0.13868 3.475 0.000512 ***
age:sex -0.02444 0.97586 0.02211 -1.105 0.268992
---
Signif. codes: 0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
exp(coef) exp(-coef) lower .95 upper .95
age 1.0423 0.9594 0.9781 1.111
sex 2.8153 0.3552 0.1812 43.747
ph.ecog 1.6191 0.6176 1.2337 2.125
age:sex 0.9759 1.0247 0.9345 1.019
Concordance= 0.648 (se = 0.03 )
Likelihood ratio test= 21.23 on 4 df, p=3e-04
Wald test = 21.6 on 4 df, p=2e-04
Score (logrank) test = 22 on 4 df, p=2e-045.6.3 Términos no lineales (splines)
Para capturar efectos no lineales:
# Efecto no lineal de edad usando splines
library(splines)
cox_spline <- coxph(Surv(time, status) ~ ns(age, df = 3) + sex + ph.ecog,
                    data = lung)
summary(cox_spline)
Call:
coxph(formula = Surv(time, status) ~ ns(age, df = 3) + sex +
ph.ecog, data = lung)
n= 167, number of events= 120
coef exp(coef) se(coef) z Pr(>|z|)
ns(age, df = 3)1 -0.1268 0.8809 0.4256 -0.298 0.76581
ns(age, df = 3)2 1.6708 5.3164 1.3340 1.252 0.21040
ns(age, df = 3)3 0.8402 2.3169 0.5354 1.569 0.11660
sex -0.5187 0.5953 0.1985 -2.613 0.00899 **
ph.ecog 0.4691 1.5986 0.1386 3.386 0.00071 ***
---
Signif. codes: 0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
exp(coef) exp(-coef) lower .95 upper .95
ns(age, df = 3)1 0.8809 1.1352 0.3825 2.0287
ns(age, df = 3)2 5.3164 0.1881 0.3891 72.6311
ns(age, df = 3)3 2.3169 0.4316 0.8112 6.6173
sex 0.5953 1.6798 0.4034 0.8785
ph.ecog 1.5986 0.6256 1.2184 2.0973
Concordance= 0.649 (se = 0.032 )
Likelihood ratio test= 22.12 on 5 df, p=5e-04
Wald test = 21.76 on 5 df, p=6e-04
Score (logrank) test = 22.32 on 5 df, p=5e-046 Tópicos avanzados
6.1 Riesgos competitivos
Los riesgos competitivos ocurren cuando un sujeto puede experimentar uno de varios eventos mutuamente excluyentes (por ejemplo, morir por cáncer frente a morir por enfermedad cardiovascular). La ocurrencia de un evento impide observar los demás, lo que genera un tipo de censura informativa que no puede tratarse con los métodos estándar.
Interpretación práctica: en vez de preguntar “¿cuándo sucede el evento de interés, sea lo que sea lo demás?”, ahora preguntamos “¿cuándo sucede este evento, sabiendo que pueden ocurrir otros primero?”. Por eso necesitamos métricas que contabilicen correctamente el impacto de los eventos competidores.
6.1.1 Función de incidencia acumulada
La función de incidencia acumulada (CIF) para el evento tipo \(k\) es:
\[F_k(t) = P(T \leq t, \text{tipo } = k) = \int_0^t S(u) h_k(u) \, du\]
donde \(S(t)\) es la supervivencia global (probabilidad de no haber sufrido ningún evento) y \(h_k(t)\) es el riesgo causa-específico (cause-specific hazard).
Propiedad: \(\sum_{k=1}^K F_k(\infty) = 1\) si todos eventualmente experimentan algún evento.
Distinción clave: existen dos riesgos distintos que no deben confundirse (17,18):
- El riesgo causa-específico \(h_k(t)\), que modela la tasa instantánea del evento \(k\) entre los sujetos aún libres de cualquier evento. Es el análogo natural del hazard en ausencia de competencia.
- El riesgo de subdistribución \(h_k^*(t)\), que modela la tasa instantánea del evento \(k\) entre los sujetos que aún no han sufrido el evento \(k\) (incluyendo a los que ya sufrieron otro evento, que permanecen en el denominador). Es la cantidad directamente ligada a la CIF mediante \(F_k(t) = 1 - \exp(-\int_0^t h_k^*(u)\,du)\).
En presencia de competencia, un mismo coeficiente estimado con el modelo causa-específico (Cox) y con el modelo de subdistribución (Fine-Gray) puede tener signo y magnitud diferentes, porque responden a preguntas distintas.
6.1.2 Test de Gray
El test de Gray (18) compara CIFs entre grupos considerando los eventos competitivos.
Interpretación de salida: cuando el test sugiere diferencia entre grupos, significa que la probabilidad acumulada de experimentar el evento de interés (tipo \(k\)) a lo largo del tiempo difiere, incluso teniendo en cuenta que puede ocurrir antes un evento competitivo. Es decir, el resultado está directamente alineado con la pregunta clínica/predictiva sobre “incidencia del evento”.
# Simular datos con riesgos competitivos
set.seed(123)
n <- 200
tiempo <- rexp(n, 0.01)
evento <- sample(0:2, n, replace = TRUE, prob = c(0.3, 0.4, 0.3))
# 0 = censura, 1 = evento tipo 1, 2 = evento tipo 2
grupo <- rbinom(n, 1, 0.5)

datos_cr <- data.frame(tiempo, evento, grupo)

# Estimar CIF
cif_fit <- cuminc(ftime = datos_cr$tiempo,
                  fstatus = datos_cr$evento,
                  group = datos_cr$grupo)

# Gráfico
plot(cif_fit, lty = 1:2, col = 1:2,
     xlab = "Tiempo", ylab = "Incidencia acumulada",
     main = "Funciones de incidencia acumulada por grupo")
legend("topleft",
       legend = c("Grupo 0, Evento 1", "Grupo 0, Evento 2",
                  "Grupo 1, Evento 1", "Grupo 1, Evento 2"),
       lty = rep(1:2, 2), col = rep(1:2, each = 2))

# Test de Gray
print(cif_fit)
Tests:
stat pv df
1 0.7391073 0.38994699 1
2 3.3594887 0.06681881 1
Estimates and Variances:
$est
200 400 600
0 1 0.5611684 0.6742783 0.6742783
1 1 0.4600541 0.5299475 NA
0 2 0.2228946 0.2228946 0.2743081
1 2 0.3709500 0.4116342 NA
$var
200 400 600
0 1 0.004210873 0.005942215 0.005942215
1 1 0.002719739 0.003628017 NA
0 2 0.002681503 0.002681503 0.005927133
1 2 0.002613671 0.003064468 NA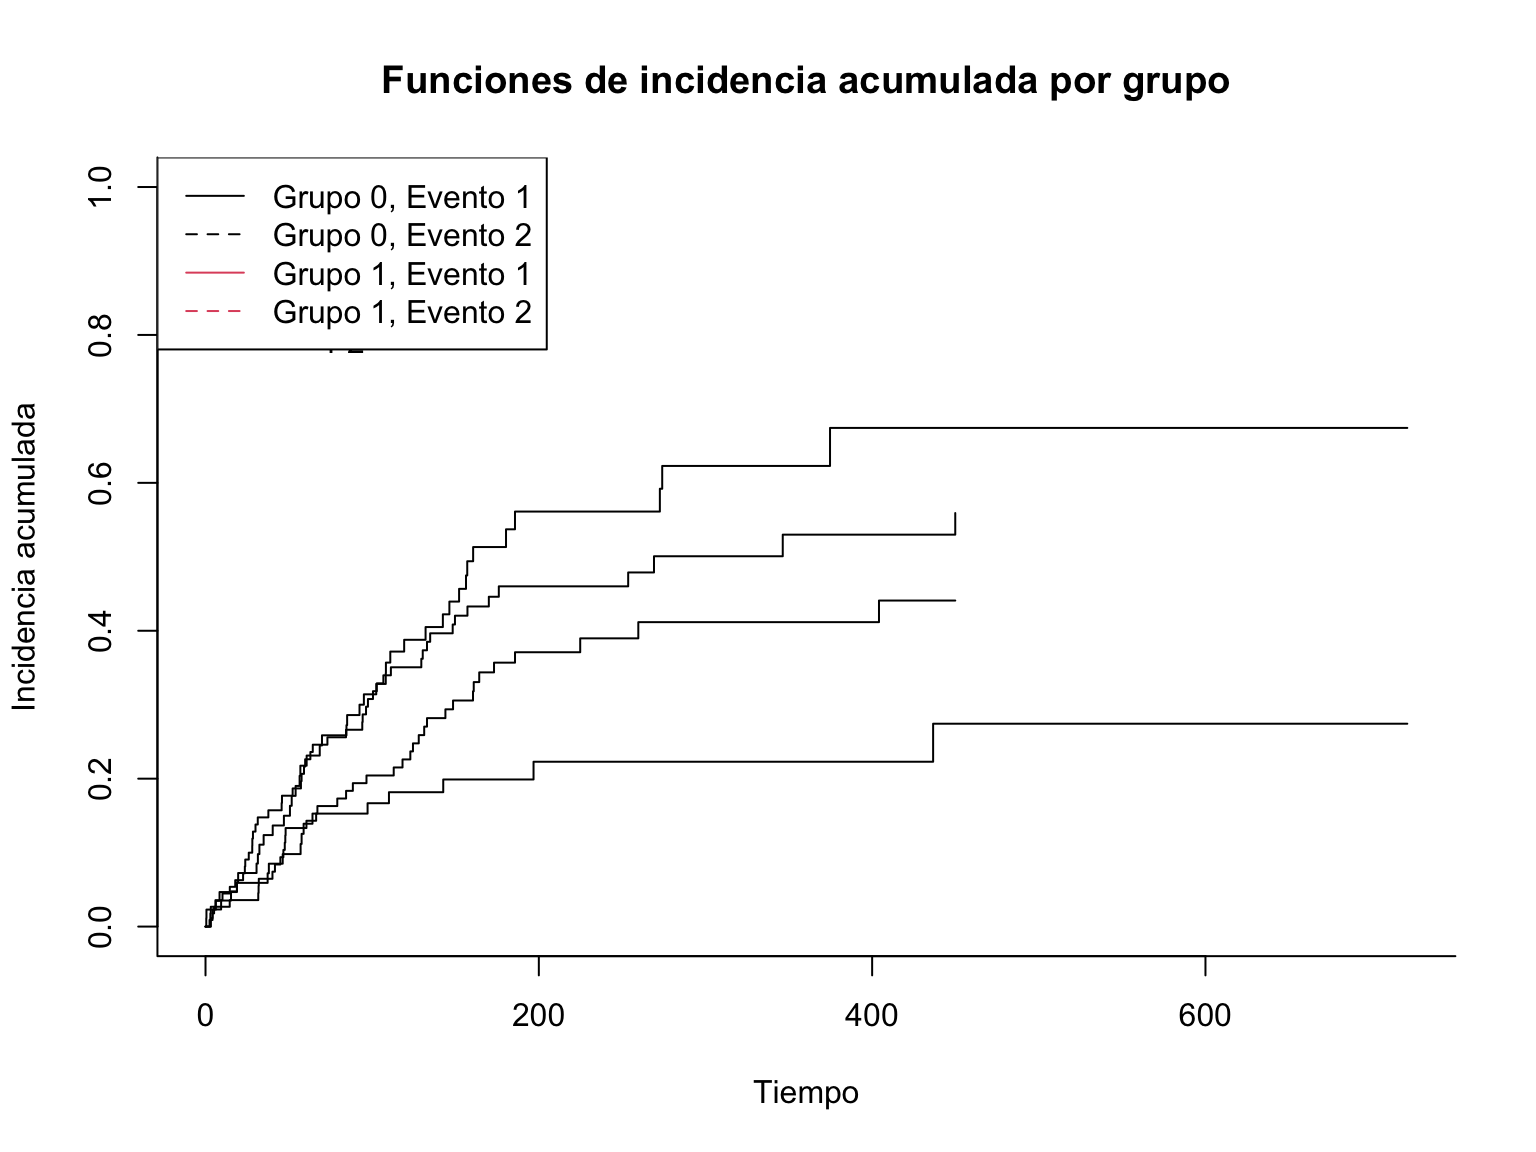
6.1.3 Modelo de subdistribución de Fine-Gray
El modelo de Fine-Gray (17) modela directamente la CIF a través del riesgo de subdistribución:
Interpretación práctica (muy ligada a la pregunta clínica): cuando la pregunta es “¿qué probabilidad acumulada tengo de observar el evento de interés tipo \(k\) antes de un horizonte de tiempo \(t\), aunque pueda ocurrir un competidor primero?”, Fine-Gray es el modelo más directamente alineado. Por eso, cuando miras $ ()$, lo que te está diciendo (en el lenguaje correcto para supervivencia competitiva) es cómo cambia la incidencia acumulada esperada del evento \(k\).
\[h_k^*(t \mid \mathbf{X}) = h_{0k}^*(t) \exp(\boldsymbol{\beta}_k' \mathbf{X})\]
donde \(h_k^*(t)\) es el riesgo de subdistribución (subdistribution hazard). A diferencia del modelo causa-específico de Cox, el modelo de Fine-Gray mantiene en el conjunto de riesgo a los sujetos que ya han sufrido un evento competitivo (ponderándolos de forma decreciente), de modo que \(\exp(\beta)\) tiene una interpretación directa sobre la incidencia acumulada: un \(\text{HR} > 1\) indica mayor probabilidad de sufrir el evento \(k\) a lo largo del tiempo. Esta es la razón por la que es el modelo preferido cuando el objetivo es predecir el riesgo absoluto de un evento concreto, mientras que el modelo causa-específico se prefiere para estudiar la etiología del evento (3,17).
# Modelo de Fine-Gray
fg_fit <- crr(ftime = datos_cr$tiempo,
              fstatus = datos_cr$evento,
              cov1 = matrix(datos_cr$grupo, ncol = 1),
              failcode = 1)

summary(fg_fit)
Competing Risks Regression
Call:
crr(ftime = datos_cr$tiempo, fstatus = datos_cr$evento, cov1 = matrix(datos_cr$grupo,
ncol = 1), failcode = 1)
coef exp(coef) se(coef) z p-value
matrix(datos_cr$grupo, ncol = 1)1 -0.166 0.847 0.207 -0.799 0.42
exp(coef) exp(-coef) 2.5% 97.5%
matrix(datos_cr$grupo, ncol = 1)1 0.847 1.18 0.565 1.27
Num. cases = 200
Pseudo Log-likelihood = -426
Pseudo likelihood ratio test = 0.61 on 1 df,Cómo leer la salida de crr: coef es el efecto sobre el riesgo de subdistribución (log-HR de Fine-Gray), exp(coef) su HR, y se/z/p-value el error estándar y el test de Wald. Un exp(coef) > 1 indica que el grupo (o covariable) se asocia con mayor incidencia acumulada del evento tipo 1. Recuerda que este HR no es el mismo que el del Cox causa-específico: aquí responde a la pregunta predictiva sobre la CIF.
6.2 Modelos de fragilidad
Los modelos de fragilidad introducen heterogeneidad no observada mediante un efecto aleatorio:
Interpretación humana: imagina que hay “pacientes con distinta tendencia natural” al evento (por factores que no medimos). En vez de forzar una única tendencia media para todos, el modelo permite que cada grupo/individuo tenga un nivel latente de riesgo (la fragilidad). Esto suele mejorar la calibración y los errores estándar cuando hay dependencia entre observaciones.
\[h_i(t \mid \mathbf{X}_i, Z_i) = Z_i h_0(t) \exp(\boldsymbol{\beta}' \mathbf{X}_i)\]
donde \(Z_i\) es la fragilidad (usualmente \(Z_i \sim \text{Gamma}(\theta, \theta)\) con \(E[Z_i] = 1\)).
Motivación: cuando los datos están agrupados (pacientes dentro de hospitales, hermanos en la misma camada, eventos recurrentes del mismo sujeto), las observaciones dentro de un grupo comparten factores no medidos. El efecto aleatorio \(Z_i\) captura esta correlación: los sujetos con \(Z_i > 1\) son más “frágiles” (mayor riesgo) y los que comparten grupo tienden a parecerse. El parámetro \(\theta\) controla la dispersión de la fragilidad (\(\theta \to 0\) indica homogeneidad). Ignorar esta agrupación puede llevar a errores estándar subestimados e inferencia incorrecta (14,19).
Aplicaciones: Datos agrupados (pacientes dentro de hospitales) o eventos recurrentes.
# Modelo de fragilidad gamma
data(rats, package = "survival")

frailty_fit <- coxph(Surv(time, status) ~ rx + frailty(litter),
                     data = rats)
summary(frailty_fit)
Call:
coxph(formula = Surv(time, status) ~ rx + frailty(litter), data = rats)
n= 300, number of events= 42
coef se(coef) se2 Chisq DF p
rx 0.7271 0.3183 0.3126 5.22 1.00 0.022
frailty(litter) 63.05 47.67 0.067
exp(coef) exp(-coef) lower .95 upper .95
rx 2.069 0.4833 1.109 3.861
Iterations: 6 outer, 23 Newton-Raphson
Variance of random effect= 2.021201 I-likelihood = -217.5
Degrees of freedom for terms= 1.0 47.7
Concordance= 0.923 (se = 0.014 )
Likelihood ratio test= 88.54 on 48.63 df, p=4e-04Cómo leer la salida: además del coeficiente de rx, verás la varianza estimada de la fragilidad (el término frailty(litter) con su propia sección). Si esa varianza es claramente mayor que cero, hay heterogeneidad entre camadas (litters) que el efecto fijo no explica; si fuera despreciable, la fragilidad no aporta y bastaría un Cox ordinario.
6.3 Eventos recurrentes
Para sujetos que pueden experimentar el evento múltiples veces (p. ej., hospitalizaciones, infecciones). Cada sujeto puede contribuir con varios intervalos de riesgo.
6.3.1 Procesos de conteo
Modelamos el número de eventos \(N_i(t)\) usando modelos de intensidad:
\[\lambda_i(t \mid \mathbf{X}_i) = Y_i(t) h_0(t) \exp(\boldsymbol{\beta}' \mathbf{X}_i)\]
donde \(Y_i(t)\) indica si el sujeto \(i\) está en riesgo en el tiempo \(t\). Esta formulación de procesos de conteo es la base teórica general del modelo de Cox (16), y permite representar tanto la censura por la derecha como los eventos recurrentes con datos en formato \((t_{\text{start}}, t_{\text{stop}}]\).
6.3.2 Modelos para eventos recurrentes
- Andersen-Gill (AG): Todos los eventos se tratan igualmente (16). Modelo de intensidad con un único efecto de covariable; asume independencia entre eventos del mismo sujeto y usa errores robustos (sandwich) por sujeto.
- Prentice-Williams-Peterson (PWP): Estratifica por número de evento (el sujeto no puede sufrir el evento \(k\) hasta no haber sufrido el \(k-1\)).
- Wei-Lin-Weissfeld (WLW): Modelo marginal para cada evento.
La elección entre AG, PWP y WLW depende de si el interés está en el tiempo total de eventos (AG), en el tiempo entre eventos consecutivos (PWP) o en el marginal por evento (WLW) (3,14).
# Ejemplo con datos simulados de eventos recurrentes
datos_rec <- data.frame(
  id = rep(1:50, each = 3),
  evento = sample(0:1, 150, replace = TRUE),
  tiempo = abs(rnorm(150, 10, 3)),
  x1 = rep(rnorm(50), each = 3)
)

# Modelo Andersen-Gill
ag_fit <- coxph(Surv(tiempo, evento) ~ x1 + cluster(id),
                data = datos_rec)
summary(ag_fit)
Call:
coxph(formula = Surv(tiempo, evento) ~ x1, data = datos_rec,
cluster = id)
n= 150, number of events= 71
coef exp(coef) se(coef) robust se z Pr(>|z|)
x1 0.08985 1.09401 0.12400 0.13615 0.66 0.509
exp(coef) exp(-coef) lower .95 upper .95
x1 1.094 0.9141 0.8378 1.429
Concordance= 0.525 (se = 0.045 )
Likelihood ratio test= 0.53 on 1 df, p=0.5
Wald test = 0.44 on 1 df, p=0.5
Score (logrank) test = 0.52 on 1 df, p=0.5, Robust = 0.4 p=0.5
(Note: the likelihood ratio and score tests assume independence of
observations within a cluster, the Wald and robust score tests do not).Cómo leer la salida: el modelo Andersen-Gill ajusta todos los intervalos como si fueran independientes, pero cluster(id) corrige los errores estándar (robustos, tipo sandwich) por la correlación dentro del mismo sujeto. Los coef se interpretan igual que en Cox (log-HR), pero ahora describen el efecto sobre la tasa de recurrencia (intensidad), no sobre un único evento.
6.4 Análisis de concordancia
El índice de concordancia (C-index) mide la capacidad discriminativa del modelo: en términos sencillos, evalúa si los pacientes a los que el modelo asigna “peor pronóstico” tienden a experimentar el evento antes que los pacientes con pronóstico mejor.
En un mundo ideal, el modelo clasificaría todas las parejas correctamente. En la práctica, los empates y la censura hacen que el valor esté entre 0 y 1.
El C-index se estima con la fórmula habitual (aquí como probabilidad condicional):
\[C = P(\hat{T}_i > \hat{T}_j \mid T_i > T_j)\]
- \(C = 0.5\): Sin capacidad discriminativa (aleatorio)
- \(C = 1\): Discriminación perfecta
# Calcular C-index
c_index <- concordance(cox_fit)
print(c_index)
Call:
concordance.coxph(object = cox_fit)
n= 167
Concordance= 0.6532 se= 0.0289
concordant discordant tied.x tied.y tied.xy
6900 3664 0 11 0 # Usando paquete survival
survConcordance(Surv(time, status) ~ predict(cox_fit), data = lung)$concordance
concordant
0.6531617
$stats
concordant discordant tied.risk tied.time std(c-d)
6900.000 3664.000 0.000 11.000 648.288
$n
[1] 167
$std.err
std(c-d)
0.03068383
$call
survConcordance(formula = Surv(time, status) ~ predict(cox_fit),
data = lung)
attr(,"class")
[1] "survConcordance"Cómo leer la salida: concordance da el valor C y su error estándar. Un C = 0.5 equivale a tirar una moneda (sin capacidad discriminativa) y C = 1 a discriminación perfecta; en la práctica clínica, valores entre 0.6 y 0.7 se consideran aceptables y por encima de 0.8, muy buenos. Un valor alrededor de 0.65 indica que el modelo acierta a ordenar (peor pronóstico = evento antes) de forma claramente mejor que el azar, pero con margen de mejora.
6.5 Validación del modelo
6.5.1 Validación cruzada
Aquí la validación cruzada intenta responder una pregunta concreta: ¿se comporta el modelo de forma similar en datos no usados para ajustarlo?
Cómo leer la salida (C-index medio y desviación estándar):
- El C-index medio (CV) es una estimación del rendimiento esperado.
- La desviación estándar te informa de la estabilidad: si es grande, el rendimiento depende mucho de qué pliegues toquen.
- Si el modelo tiene buena discriminación (C-index alto) en todos los pliegues, es señal de que no es solo “casualidad” del ajuste.
# Validación cruzada 10-fold
set.seed(456)
k <- 10
folds <- sample(1:k, nrow(lung), replace = TRUE)

c_indices <- numeric(k)
for (i in 1:k) {
  train <- lung[folds != i, ]
  test <- lung[folds == i, ]

  modelo <- coxph(Surv(time, status) ~ age + sex + ph.ecog, data = train)
  pred <- predict(modelo, newdata = test)

  c_indices[i] <- concordance(Surv(time, status) ~ pred, data = test)$concordance
}

cat("C-index medio (CV):", mean(c_indices), "\n")
C-index medio (CV): 0.3761658 cat("Desviación estándar:", sd(c_indices), "\n")Desviación estándar: 0.09477215 6.5.2 Calibración
La calibración evalúa si las probabilidades predichas coinciden con lo que realmente ocurre. En supervivencia, no es solo “qué tan bien discrimina” (eso es C-index), sino si el nivel absoluto de probabilidad que asigna el modelo tiene sentido.
Cómo leer el gráfico de calibración (de rms::calibrate):
- Si la curva se aproxima a la diagonal (ideal), las probabilidades a ese horizonte temporal están bien calibradas.
- Si aparece sistemáticamente por encima o por debajo, el modelo tiende a sobreestimar o subestimar el riesgo (o, equivalente, la supervivencia) en ese rango.
# Gráfico de calibración
library(rms)

dd <- datadist(lung)
options(datadist = "dd")

cox_rms <- cph(Surv(time, status) ~ age + sex + ph.ecog,
               data = lung, x = TRUE, y = TRUE, surv = TRUE, time.inc = 365)

cal <- calibrate(cox_rms, u = 365, B = 50)
Using Cox survival estimates at 365 Daysplot(cal, main = "Gráfico de calibración")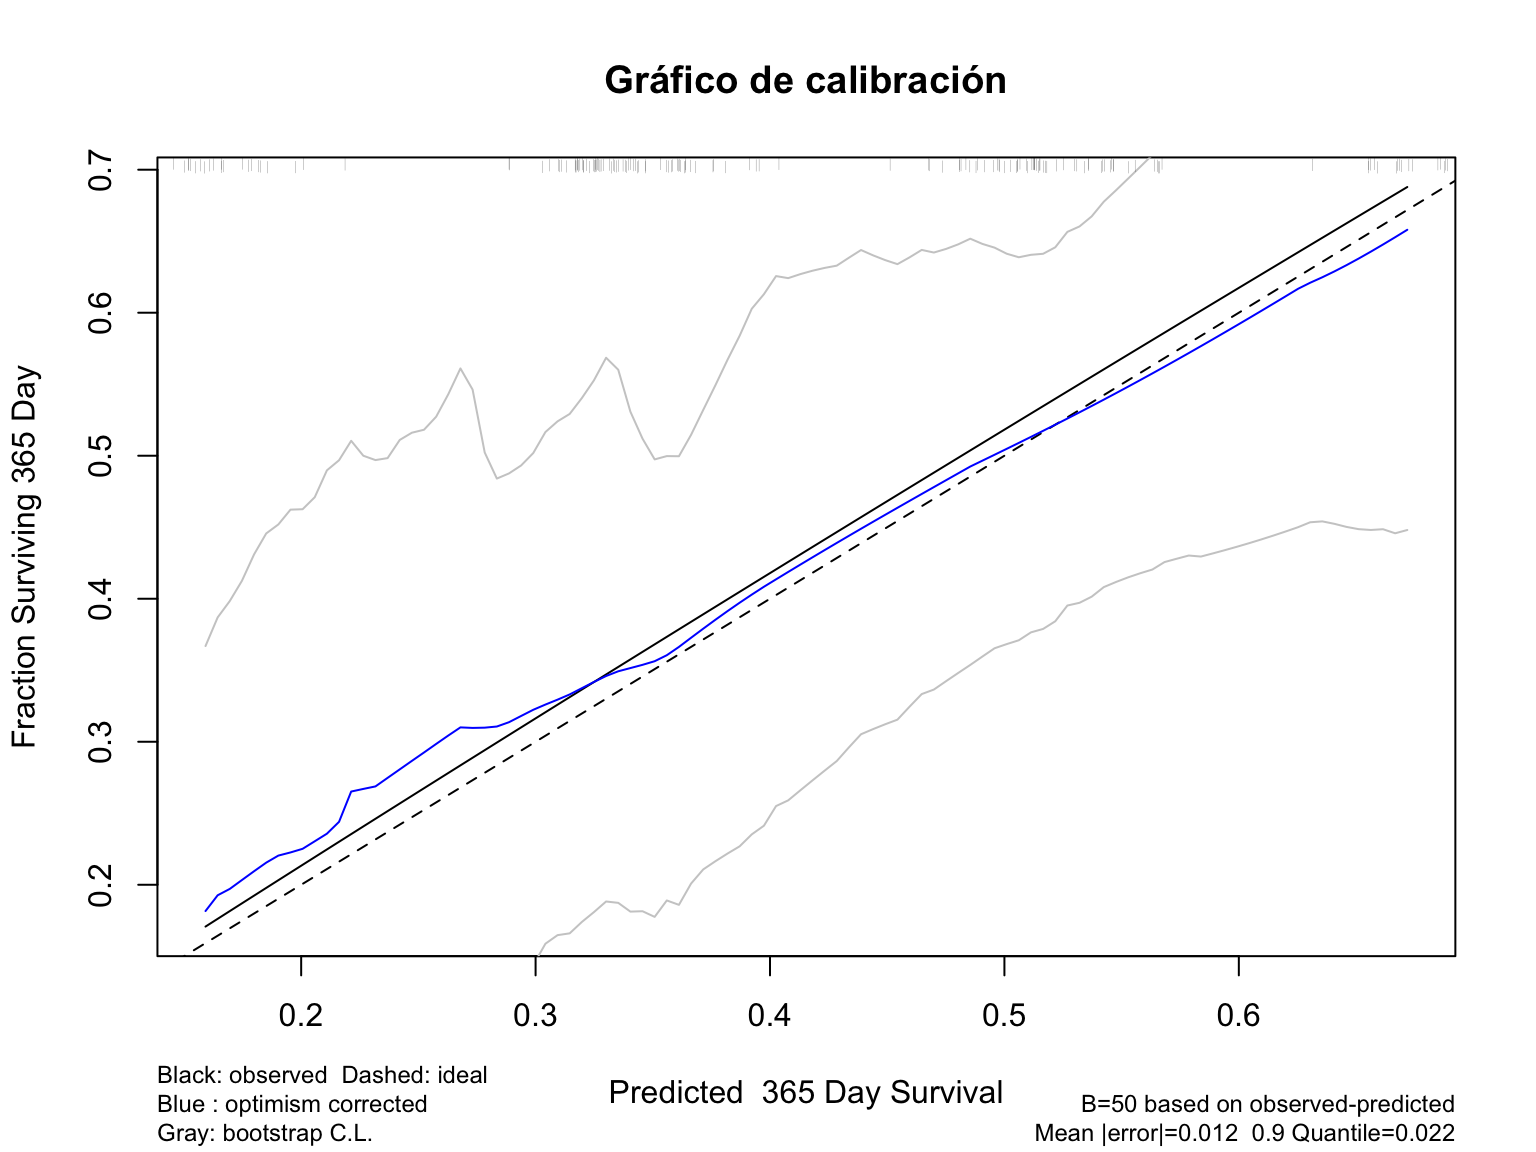
7 Predicción de supervivencia
7.1 Predicción individual
Para un nuevo paciente con covariables \(\mathbf{X}_{\text{new}}\), la función de supervivencia predicha es:
Interpretación: esta curva predicha $ (t_{})$ responde a la pregunta “¿cuánta supervivencia libre de evento espera el modelo para este perfil, a cada horizonte t?”.
Rigor: recuerda que es una curva condicional: depende del conjunto de covariables observado, del modelo (aquí Cox) y de suposiciones (p.ej., riesgos proporcionales). \[\hat{S}(t \mid \mathbf{X}_{\text{new}}) = \hat{S}_0(t)^{\exp(\hat{\boldsymbol{\beta}}' \mathbf{X}_{\text{new}})}\]
donde \(\hat{S}_0(t)\) es la función de supervivencia basal estimada.
# Definir perfiles de pacientes
perfiles <- data.frame(
  age = c(50, 50, 70, 70),
  sex = c(1, 2, 1, 2),
  ph.ecog = c(0, 0, 2, 2),
  ph.karno = c(100, 100, 100, 100),
  pat.karno = c(100, 100, 100, 100),
  meal.cal = c(1000, 1000, 1000, 1000),
  wt.loss = c(0, 0, 0, 0)
)

# Predicciones
pred_surv <- survfit(cox_fit, newdata = perfiles)

# Gráfico
plot(pred_surv, col = 1:4, lwd = 2,
     xlab = "Tiempo (días)", ylab = "Probabilidad de supervivencia",
     main = "Curvas de supervivencia predichas")
legend("topright",
       legend = c("50 años, Hombre, ECOG 0",
                  "50 años, Mujer, ECOG 0",
                  "70 años, Hombre, ECOG 2",
                  "70 años, Mujer, ECOG 2"),
       col = 1:4, lwd = 2)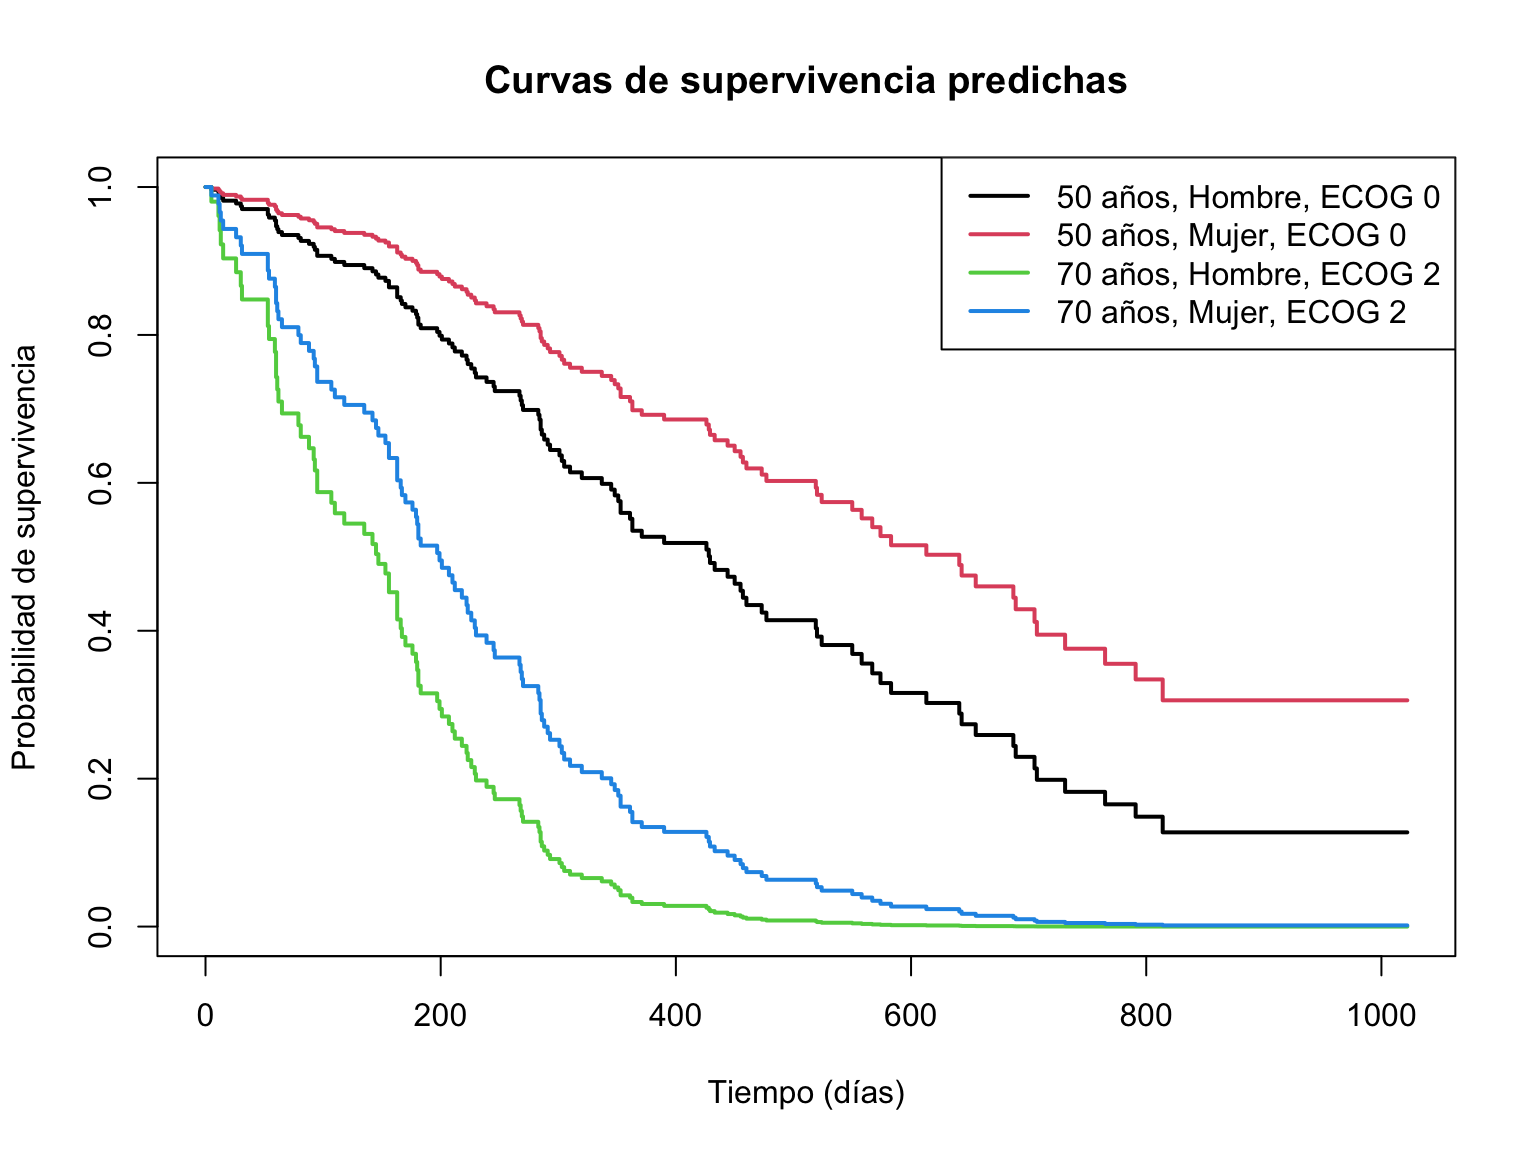
7.2 Probabilidades de supervivencia
Después de ajustar Cox, la salida summary(pred_surv, times = ...) te da probabilidades estimadas de supervivencia para cada perfil, en los tiempos pedidos (aquí 1 y 2 años).
Cómo leer la salida:
- Para un perfil concreto (con covariables específicas), el valor en
surves $ (t)$, es decir, “probabilidad de que el paciente no haya tenido el evento antes de t”. - Si comparas perfiles, valores más bajos implican peor supervivencia esperada (evento más probable antes).
- No es una probabilidad “de ocurrencia final” por sí sola: está condicionada al modelo, a las covariables y al horizonte temporal \(t\).
# Probabilidad de sobrevivir 1 año (365 días)
summary(pred_surv, times = 365)
Call: survfit(formula = cox_fit, newdata = perfiles)
time n.risk n.event survival1 survival2 survival3 survival4
365 49 87 0.535 0.698 0.0332 0.141# Probabilidad de sobrevivir 2 años
summary(pred_surv, times = 730)Call: survfit(formula = cox_fit, newdata = perfiles)
time n.risk n.event survival1 survival2 survival3 survival4
730 10 116 0.198 0.395 0.000149 0.006327.3 Nomogramas
Los nomogramas permiten cálculos gráficos de probabilidades de supervivencia.
Interpretación práctica: un nomograma traduce los valores de covariables (p.ej., edad, ECOG) a una puntuación lineal (habitualmente el linear predictor), y a partir de ahí te ayuda a leer directamente \(S(t)\) para horizontes clínicamente relevantes (p.ej., 1 y 2 años). En otras palabras, sirve como “puente” entre el modelo estadístico y una lectura clínica simple, siempre recordando que sigue siendo una predicción dependiente del modelo.
library(rms)

# Copia local con sexo como factor (no modificamos el data.frame global `lung`)
lung_nom <- transform(lung, sex = factor(sex))

dd <- datadist(lung_nom)
options(datadist = "dd")

# Modelo usando rms
cox_nom <- cph(Surv(time, status) ~ age + sex + ph.ecog,
               data = lung_nom, x = TRUE, y = TRUE, surv = TRUE, time.inc = 365)

# Funciones de supervivencia a 1 y 2 años
Sfun <- Survival(cox_nom)

# Nomograma
nom <- nomogram(
  cox_nom,
  fun = list(
    function(lp) Sfun(365, lp),
    function(lp) Sfun(730, lp)
  ),
  funlabel = c("S(1 año)", "S(2 años)")
)
plot(nom)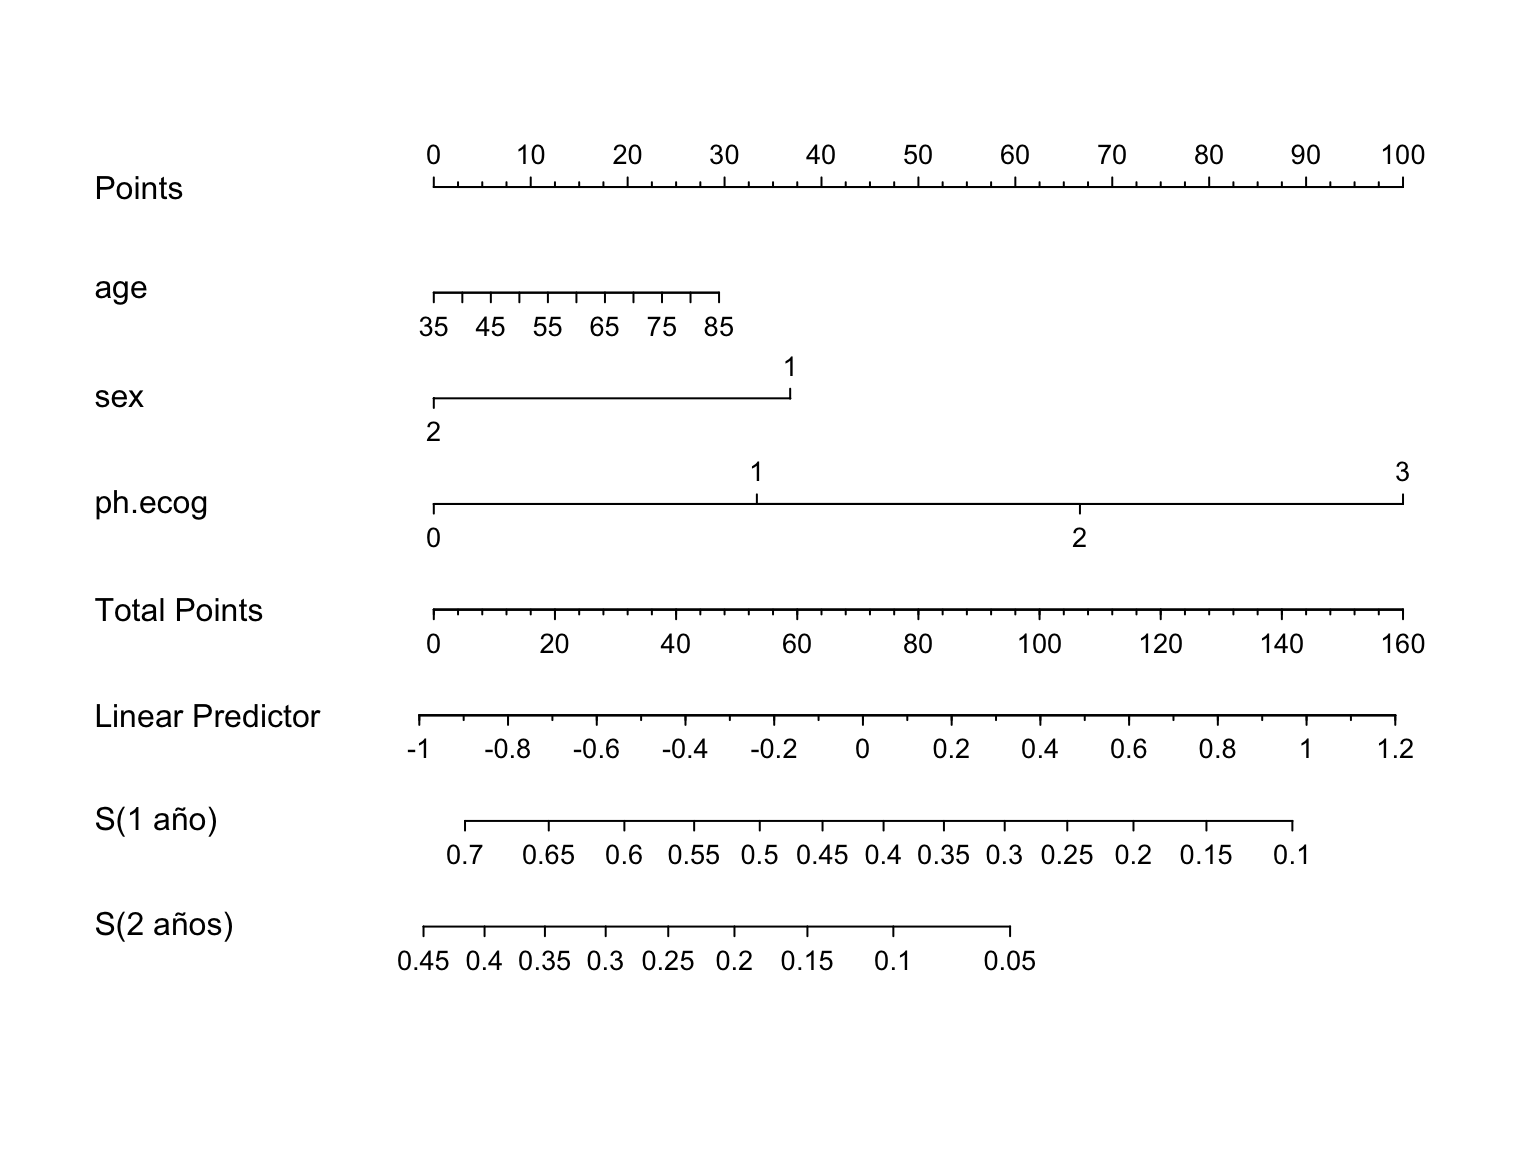
# Perfiles de pacientes para predicción
perfiles_nom <- data.frame(
  age = c(40, 50, 60, 70, 80),
  sex = factor(rep(1, 5), levels = levels(lung_nom$sex)),
  ph.ecog = rep(1, 5)
)

survest_1yr <- survest(cox_nom, newdata = perfiles_nom, times = 365)
survest_2yr <- survest(cox_nom, newdata = perfiles_nom, times = 730)

pred_table <- data.frame(
  Edad = perfiles_nom$age,
  Sexo = "Masculino",
  ECOG = perfiles_nom$ph.ecog,
  `1 año` = round(as.numeric(survest_1yr$surv), 3),
  `2 años` = round(as.numeric(survest_2yr$surv), 3)
)

print(kable(pred_table,
      caption = "Probabilidades de supervivencia predichas según edad del paciente"))
Table: Probabilidades de supervivencia predichas según edad del paciente

| Edad|Sexo      | ECOG| X1.año| X2.años|
|----:|:---------|----:|------:|-------:|
|   40|Masculino |    1|  0.406|   0.109|
|   50|Masculino |    1|  0.377|   0.091|
|   60|Masculino |    1|  0.347|   0.074|
|   70|Masculino |    1|  0.318|   0.060|
|   80|Masculino |    1|  0.288|   0.047|
8 Consideraciones prácticas
8.1 Tamaño muestral
El tamaño muestral requerido depende del número de eventos, no del número de sujetos.
Regla general: Se necesitan al menos 10 eventos por covariable para evitar sobreajuste.
\[n_{\text{eventos}} \geq 10 \times p\]
donde \(p\) es el número de covariables.
8.2 Manejo de datos faltantes
8.2.1 Análisis de casos completos
Elimina sujetos con valores faltantes. Problema: Pérdida de información y posible sesgo.
8.2.2 Imputación múltiple
Genera varios conjuntos de datos imputados y combina los resultados.
# Ejemplo de imputación múltiple con mice
library(mice)

# Crear valores faltantes artificiales
lung_na <- lung
lung_na$age[sample(1:nrow(lung_na), 20)] <- NA

# Imputación múltiple
imp <- mice(lung_na, m = 5, maxit = 10, seed = 123, printFlag = FALSE)

# Ajustar modelo en cada conjunto imputado
fit_imp <- with(imp, coxph(Surv(time, status) ~ age + sex + ph.ecog))

# Combinar resultados
pool_fit <- pool(fit_imp)
summary(pool_fit)
Cómo leer la salida de pool: al imputar m = 5 conjuntos y combinar con las reglas de Rubin, la tabla muestra estimate (coeficiente promediado entre imputaciones), std.error, statistic y p.value. La gracia es que el error estándar ya incorpora tanto la incertidumbre dentro de cada imputación como la incertidumbre entre imputaciones; ignorar esa segunda parte (haciendo un único análisis con casos completos) suele subestimar el error y dar p-valores demasiado optimistas.
8.3 Selección de variables
8.3.1 Método backward
# Modelo completo
full_model <- coxph(Surv(time, status) ~ age + sex + ph.ecog + ph.karno +
                      pat.karno + meal.cal + wt.loss,
                    data = lung)

# Selección backward usando AIC
step_model <- step(full_model, direction = "backward", trace = 0)
summary(step_model)
Call:
coxph(formula = Surv(time, status) ~ sex + ph.ecog + ph.karno +
pat.karno + wt.loss, data = lung)
n= 167, number of events= 120
coef exp(coef) se(coef) z Pr(>|z|)
sex -0.558190 0.572244 0.199202 -2.802 0.00508 **
ph.ecog 0.742983 2.102197 0.227604 3.264 0.00110 **
ph.karno 0.020366 1.020575 0.011080 1.838 0.06604 .
pat.karno -0.012401 0.987675 0.007978 -1.554 0.12008
wt.loss -0.014494 0.985611 0.007693 -1.884 0.05957 .
---
Signif. codes: 0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
exp(coef) exp(-coef) lower .95 upper .95
sex 0.5722 1.7475 0.3873 0.8456
ph.ecog 2.1022 0.4757 1.3457 3.2841
ph.karno 1.0206 0.9798 0.9987 1.0430
pat.karno 0.9877 1.0125 0.9724 1.0032
wt.loss 0.9856 1.0146 0.9709 1.0006
Concordance= 0.658 (se = 0.029 )
Likelihood ratio test= 27.28 on 5 df, p=5e-05
Wald test = 26.89 on 5 df, p=6e-05
Score (logrank) test = 27.64 on 5 df, p=4e-05Cómo leer la salida (y un aviso de rigor): step() elimina covariables de una en una buscando el menor AIC, y el summary final es el del modelo resultante. Es una herramienta cómoda, pero conviene usarla con cautela: la selección automática puede sobreajustar, y los p-valores del modelo final están sesgados (no reflejan la búsqueda previa). Mejor como guía exploratoria que como prueba concluyente.
8.3.2 Regularización (LASSO)
library(glmnet)

# Preparar datos
x <- model.matrix(~ age + sex + ph.ecog + ph.karno +
                    pat.karno + meal.cal + wt.loss - 1, data = lung)
y <- Surv(lung$time, lung$status)

# LASSO
lasso_fit <- cv.glmnet(x, y, family = "cox", alpha = 1)

# Coeficientes
coef(lasso_fit, s = "lambda.min")
7 x 1 sparse Matrix of class "dgCMatrix"
1
age 0.001091615
sex -0.264579494
ph.ecog 0.305668826
ph.karno .
pat.karno -0.001755917
meal.cal .
wt.loss . # Gráfico
plot(lasso_fit)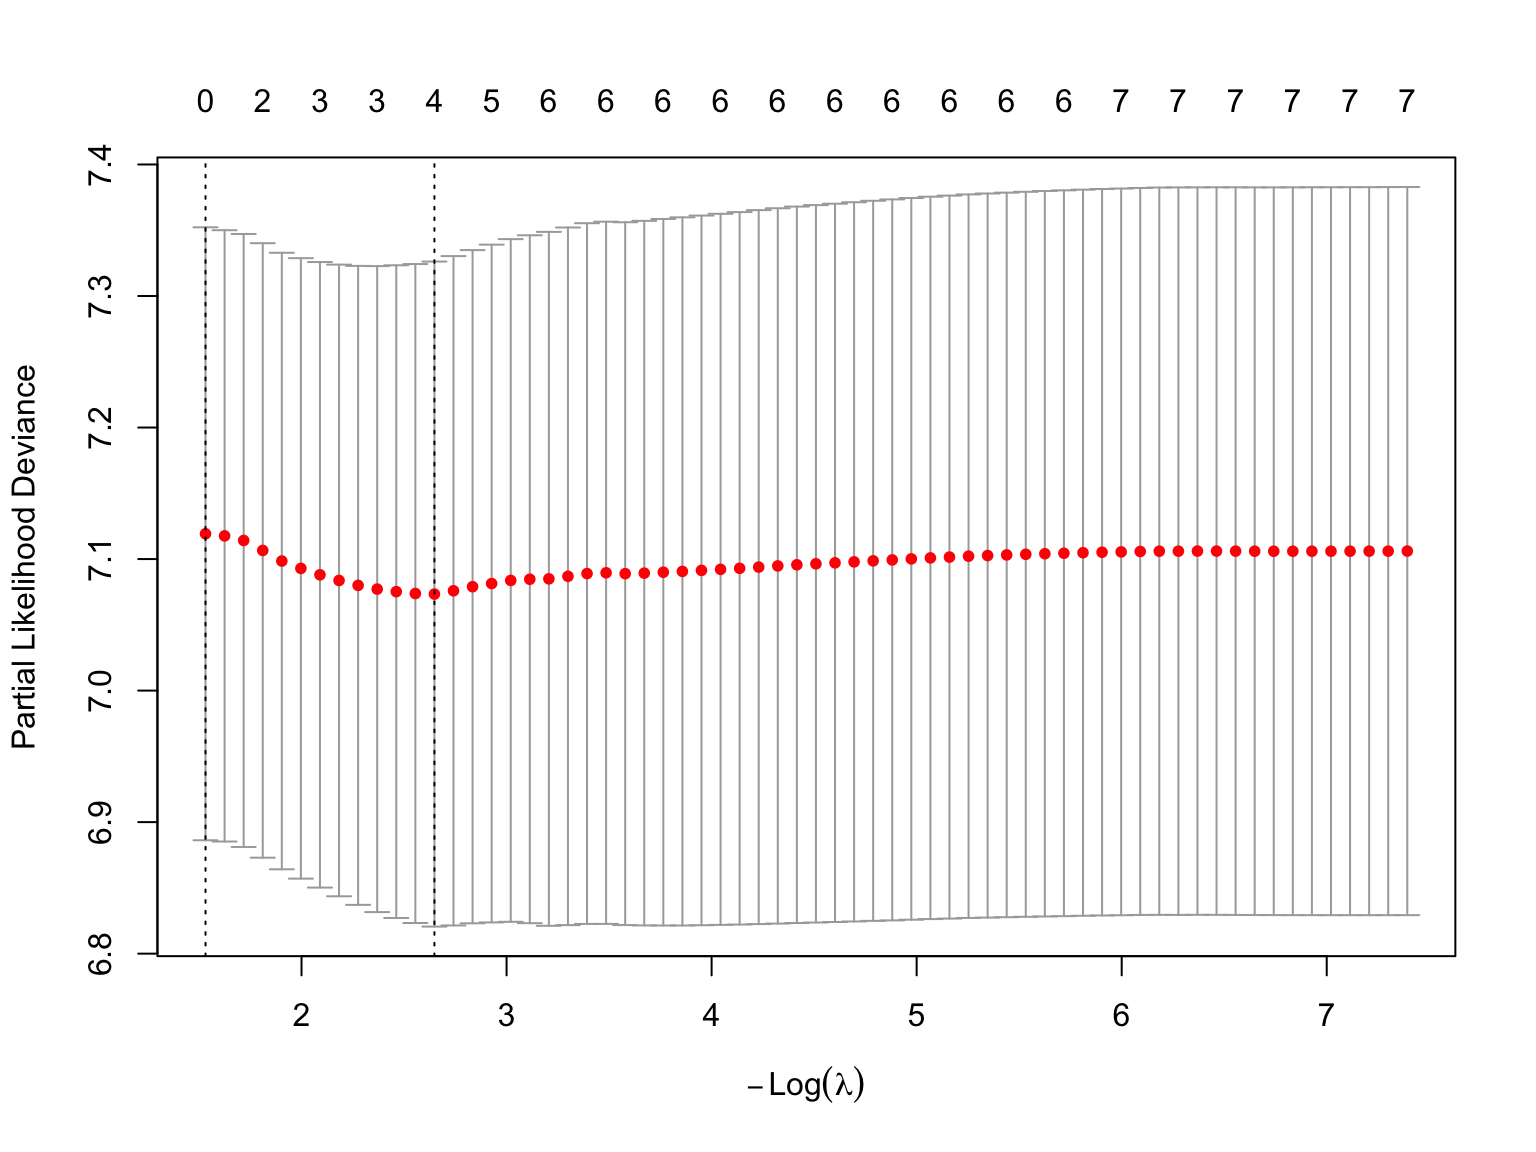
Cómo leer la salida de LASSO: la matriz de coeficientes en s = "lambda.min" es dispersa: las covariables con coeficiente 0 han sido “expulsadas” del modelo, y las que conservan un valor distinto de cero son las que el LASSO considera útiles para la predicción. El gráfico muestra la curva de validación cruzada (error según \(\log\lambda\)): lambda.min es el que minimiza el error y lambda.1se el más parsimonioso dentro de una desviación estándar (muchas veces preferible por simplicidad).
8.4 Reporte de resultados
8.4.1 Tabla de resultados
# Función para crear tabla de resultados
crear_tabla <- function(modelo) {
  coef_df <- data.frame(
    Variable = names(coef(modelo)),
    Coeficiente = coef(modelo),
    HR = exp(coef(modelo)),
    IC_inf = exp(confint(modelo)[, 1]),
    IC_sup = exp(confint(modelo)[, 2]),
    p_valor = summary(modelo)$coefficients[, "Pr(>|z|)"]
  )
  rownames(coef_df) <- NULL
  return(coef_df)
}

tabla <- crear_tabla(cox_fit)
kable(tabla, digits = 3,
caption = "Resultados del modelo de Cox: razones de riesgos (Hazard Ratios) e intervalos de confianza al 95%")| Variable | Coeficiente | HR | IC_inf | IC_sup | p_valor |
|---|---|---|---|---|---|
| age | 0.011 | 1.011 | 0.988 | 1.034 | 0.352 |
| sex | -0.554 | 0.575 | 0.387 | 0.853 | 0.006 |
| ph.ecog | 0.740 | 2.095 | 1.348 | 3.256 | 0.001 |
| ph.karno | 0.022 | 1.023 | 1.000 | 1.045 | 0.046 |
| pat.karno | -0.012 | 0.988 | 0.972 | 1.004 | 0.137 |
| meal.cal | 0.000 | 1.000 | 1.000 | 1.001 | 0.913 |
| wt.loss | -0.014 | 0.986 | 0.971 | 1.001 | 0.067 |
Cómo leer esta tabla: es el resumen definitivo para un informe. Para cada variable tienes el Coeficiente (log-HR), el HR (razón de riesgos), el IC_inf/IC_sup (IC95% del HR) y el p_valor. La lectura clínica: HR = 1 indica ausencia de efecto; HR > 1, mayor riesgo; HR < 1, menor riesgo. Si el IC95% no incluye el 1 y el p-valor es pequeño, el resultado apoya un efecto; si incluye el 1, no se puede descartar la ausencia de efecto.
8.4.2 Gráfico Forest Plot
library(forestplot)

# Extraer datos
coefs <- coef(cox_fit)
hrs <- exp(coefs)
ci <- exp(confint(cox_fit))

# Preparar datos
tabletext <- cbind(
  c("Variable", names(coefs)),
  c("HR", sprintf("%.2f", hrs)),
  c("95% IC", sprintf("(%.2f-%.2f)", ci[, 1], ci[, 2]))
)

# Forest plot
forestplot(tabletext,
           mean = c(NA, hrs),
           lower = c(NA, ci[, 1]),
           upper = c(NA, ci[, 2]),
           xlog = TRUE,
           xlab = "Razón de riesgos",
           col = fpColors(box = "royalblue", line = "darkblue"))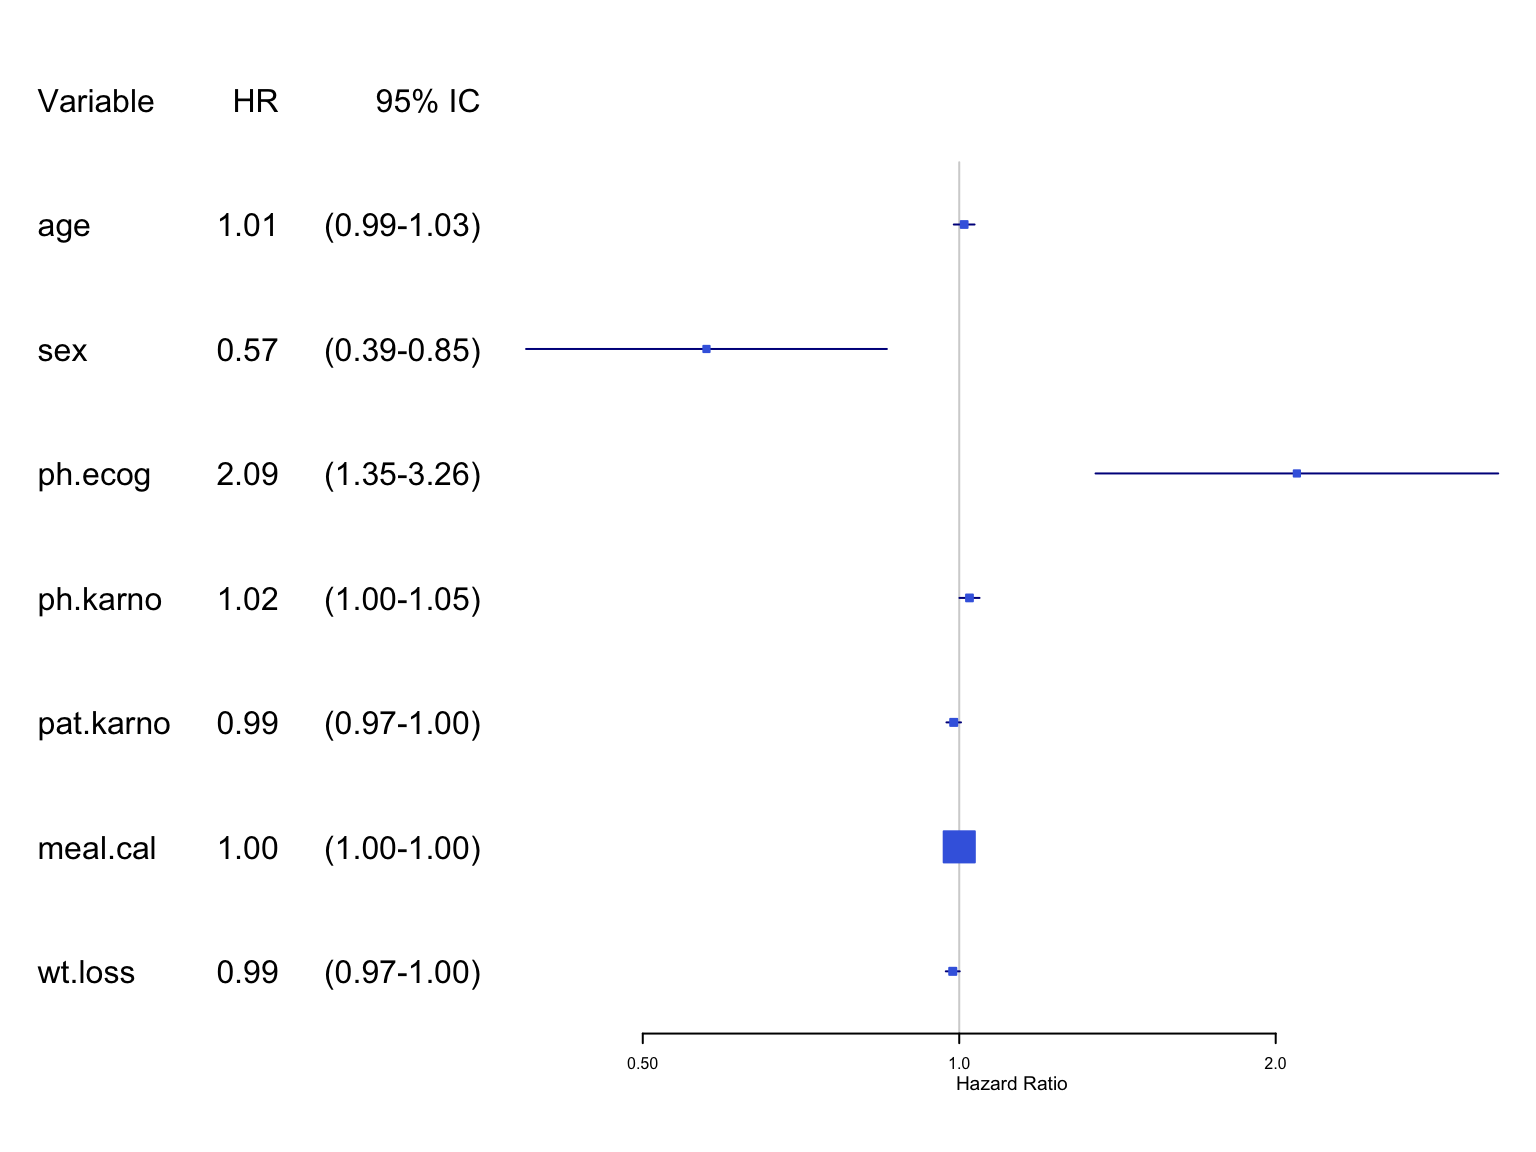
Cómo leer el forest plot: cada fila es una covariable con su HR representado como un punto y su IC95% como una línea horizontal. La referencia es la línea vertical en HR = 1. Si el intervalo no cruza esa línea, el efecto es “significativo” al 5%; si la cruza, no se puede descartar el efecto nulo. El forest plot resume de un vistazo magnitud, dirección y precisión de todos los efectos.
9 Casos de estudio
9.1 Caso 1: Trasplante de médula ósea
# Datos simulados de trasplante
set.seed(789)
n_bmt <- 137
bmt <- data.frame(
  time = abs(rnorm(n_bmt, 500, 300)),
  status = sample(0:1, n_bmt, replace = TRUE, prob = c(0.4, 0.6)),
  age = rnorm(n_bmt, 35, 10),
  donor = factor(sample(c("Relacionado", "No relacionado"), n_bmt, replace = TRUE)),
  disease = factor(sample(c("AML", "ALL", "CML"), n_bmt, replace = TRUE))
)

# KM por tipo de donante
km_bmt <- survfit(Surv(time, status) ~ donor, data = bmt)

ggsurvplot(km_bmt, data = bmt,
           pval = TRUE, conf.int = TRUE,
           risk.table = TRUE,
           xlab = "Días desde trasplante",
           ylab = "Probabilidad de supervivencia",
           title = "Supervivencia por tipo de donante",
           ggtheme = theme_minimal())

# Modelo multivariado
cox_bmt <- coxph(Surv(time, status) ~ age + donor + disease, data = bmt)
summary(cox_bmt)
Call:
coxph(formula = Surv(time, status) ~ age + donor + disease, data = bmt)
n= 137, number of events= 76
coef exp(coef) se(coef) z Pr(>|z|)
age -0.01675 0.98339 0.01247 -1.342 0.1795
donorRelacionado -0.48890 0.61330 0.24781 -1.973 0.0485 *
diseaseAML 0.09609 1.10086 0.29521 0.325 0.7448
diseaseCML 0.48582 1.62551 0.28686 1.694 0.0903 .
---
Signif. codes: 0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
exp(coef) exp(-coef) lower .95 upper .95
age 0.9834 1.0169 0.9596 1.0077
donorRelacionado 0.6133 1.6305 0.3773 0.9968
diseaseAML 1.1009 0.9084 0.6172 1.9634
diseaseCML 1.6255 0.6152 0.9264 2.8521
Concordance= 0.598 (se = 0.038 )
Likelihood ratio test= 8.03 on 4 df, p=0.09
Wald test = 8.07 on 4 df, p=0.09
Score (logrank) test = 8.17 on 4 df, p=0.09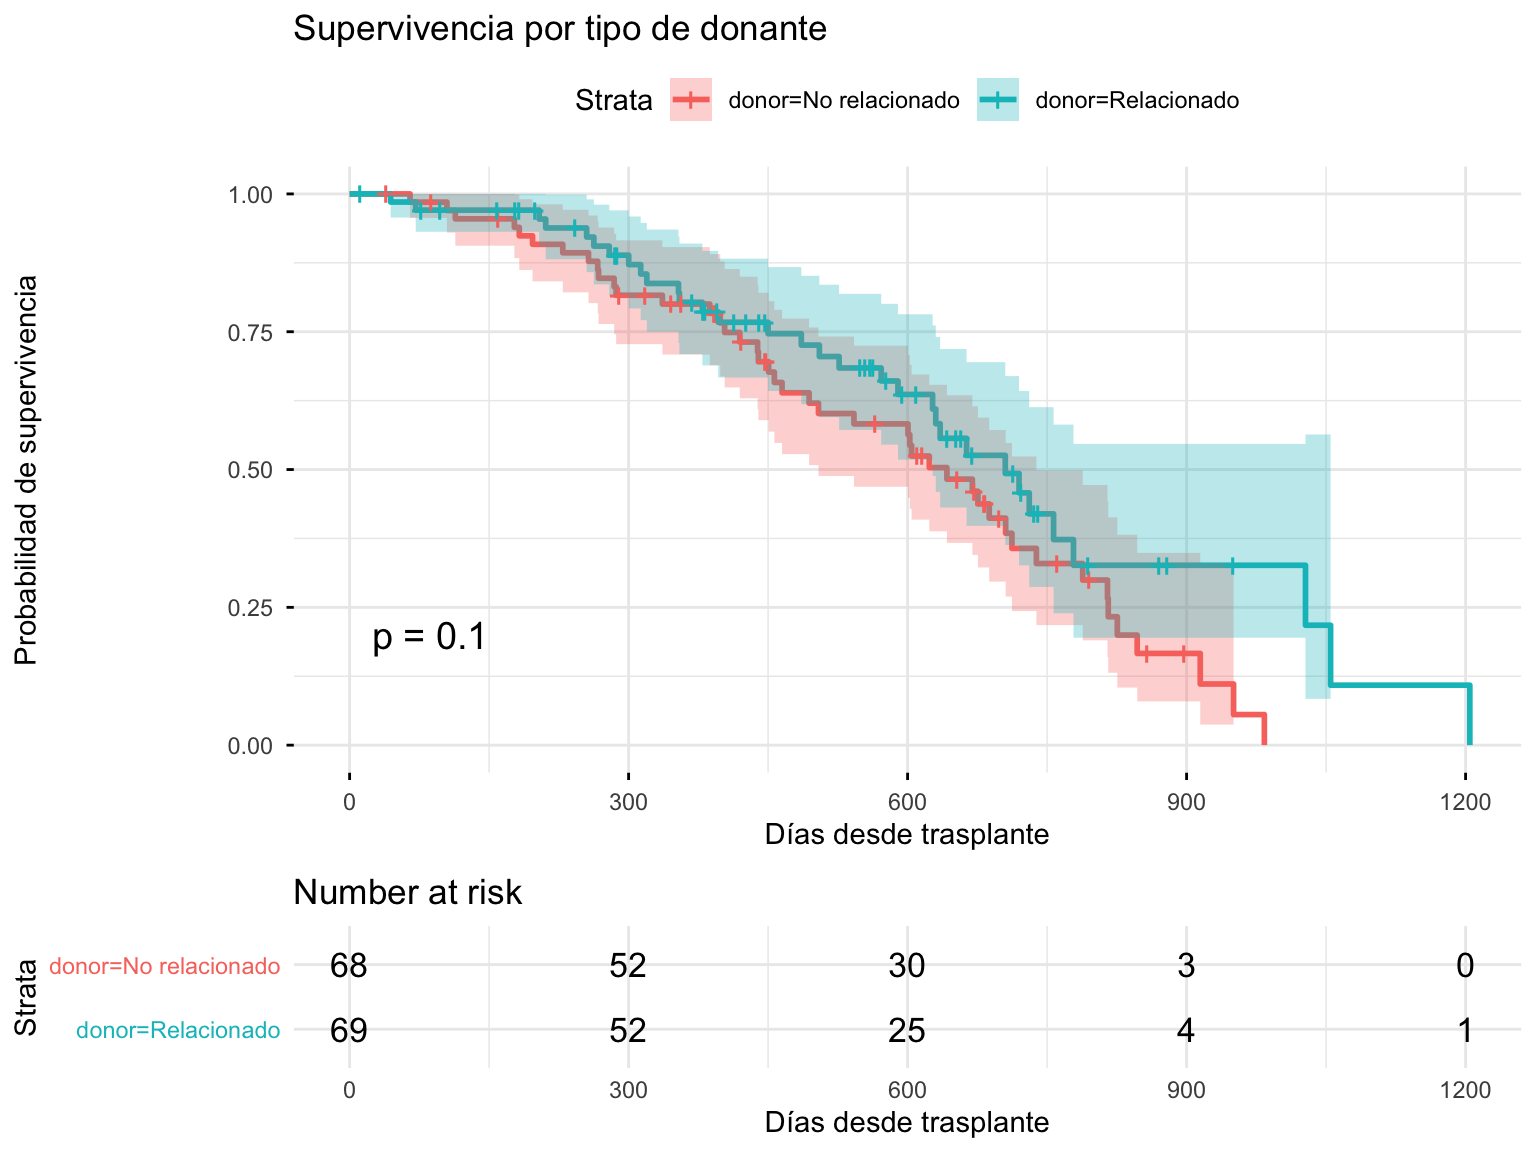
Cómo leer este caso: al ser datos simulados, la lectura es ilustrativa del flujo de trabajo, no una conclusión clínica real. El summary(cox_bmt) se interpreta igual que el Cox general: exp(coef) por fila, con la diferencia de que ahora tienes covariables categóricas (el donante y la enfermedad se desglosan en categorías de referencia). Lo importante aquí es practicar el patrón completo: KM descriptivo + modelo multivariado + inspección de HR.
9.2 Caso 2: Cáncer de mama
# Datos simulados de cáncer de mama con recaída
set.seed(321)
n_mama <- 200
mama <- data.frame(
  id = 1:n_mama,
  time = abs(rnorm(n_mama, 1000, 400)),
  status = sample(0:1, n_mama, replace = TRUE, prob = c(0.3, 0.7)),
  age = rnorm(n_mama, 55, 12),
  size = exp(rnorm(n_mama, log(2.5), 0.5)),
  nodes = rpois(n_mama, 3),
  grade = factor(sample(1:3, n_mama, replace = TRUE)),
  er = factor(sample(c("Positivo", "Negativo"), n_mama, replace = TRUE, prob = c(0.7, 0.3)))
)

# Modelo de Cox
cox_mama <- coxph(Surv(time, status) ~ age + size + nodes + grade + er,
                  data = mama)
summary(cox_mama)
Call:
coxph(formula = Surv(time, status) ~ age + size + nodes + grade +
er, data = mama)
n= 200, number of events= 134
coef exp(coef) se(coef) z Pr(>|z|)
age -0.006931 0.993093 0.007690 -0.901 0.367
size -0.007479 0.992549 0.068401 -0.109 0.913
nodes -0.033845 0.966721 0.051670 -0.655 0.512
grade2 -0.076670 0.926195 0.209897 -0.365 0.715
grade3 -0.128404 0.879498 0.225124 -0.570 0.568
erPositivo -0.354447 0.701562 0.187682 -1.889 0.059 .
---
Signif. codes: 0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
exp(coef) exp(-coef) lower .95 upper .95
age 0.9931 1.007 0.9782 1.008
size 0.9925 1.008 0.8680 1.135
nodes 0.9667 1.034 0.8736 1.070
grade2 0.9262 1.080 0.6138 1.398
grade3 0.8795 1.137 0.5657 1.367
erPositivo 0.7016 1.425 0.4856 1.013
Concordance= 0.548 (se = 0.03 )
Likelihood ratio test= 4.68 on 6 df, p=0.6
Wald test = 4.79 on 6 df, p=0.6
Score (logrank) test = 4.82 on 6 df, p=0.6# Validación de riesgos proporcionales
test_ph_mama <- cox.zph(cox_mama)
print(test_ph_mama) chisq df p
age 0.0401 1 0.84
size 0.0133 1 0.91
nodes 0.1069 1 0.74
grade 1.6304 2 0.44
er 0.6103 1 0.43
GLOBAL 2.3862 6 0.88Cómo leer cox.zph en este caso: la tabla da, para cada covariable (y globalmente), un chisq y un p-valor. Aquí conviene mirar la fila GLOBAL: si su p-valor es grande (> 0.05), la asunción de riesgos proporcionales se sostiene para el conjunto del modelo; si alguna covariable individual da un p-valor pequeño, esa variable en concreto no tiene un efecto proporcional y habría que estratificar o modelar su efecto dependiente del tiempo.
10 Software y recursos
10.1 Paquetes de R
10.2 Recursos adicionales
10.2.1 Libros
- Hosmer, Lemeshow & May (2008). Applied Survival Analysis
- Kleinbaum & Klein (2012). Survival Analysis: A Self-Learning Text
- Therneau & Grambsch (2000). Modeling Survival Data
- Klein & Moeschberger (2003). Survival Analysis: Techniques for Censored and Truncated Data
10.2.2 Cursos online
10.2.3 Documentación
11 Conclusiones
El análisis de supervivencia proporciona herramientas estadísticas poderosas para analizar datos de tiempo hasta el evento en presencia de censura. Sin embargo, la diferencia entre “un resultado bonito” y una conclusión sólida está en (i) entender qué información aporta la censura, (ii) comprobar que las asunciones del método son razonables y (iii) interpretar con rigor las métricas de salida (curvas, razones de riesgos, probabilidades, etc.) en el contexto del objetivo del estudio. En este tutorial, los puntos clave son:
- Censura: Requiere métodos especializados que no ignoran la información parcial
- Kaplan-Meier: Método no paramétrico para estimar funciones de supervivencia
- Test de log-rank: Prueba estándar para comparar curvas de supervivencia
- Modelos paramétricos: Útiles cuando se conoce la distribución subyacente
- Modelo de Cox: Modelo semiparamétrico más utilizado, flexible y robusto
- Diagnóstico: Verificación de asunciones es crucial (riesgos proporcionales, forma funcional)
- Extensiones: Riesgos competitivos, fragilidad y eventos recurrentes para situaciones más complejas
La elección del método depende de:
- Objetivo del análisis (descripción vs predicción)
- Estructura de los datos (censura, covariables, eventos competitivos)
- Asunciones que estemos dispuestos a hacer
- Tamaño muestral disponible
12 Referencias
1.
Klein JP, Moeschberger ML. Survival analysis: techniques for censored and truncated data. 2.ª ed. Springer; 2003.
2.
Hosmer Jr DW, Lemeshow S, May S. Applied survival analysis: regression modeling of time-to-event data. 2.ª ed. John Wiley & Sons; 2008.
3.
Kleinbaum DG, Klein M. Survival analysis: a self-learning text. 3.ª ed. Springer; 2012.
4.
Kaplan EL, Meier P. Nonparametric estimation from incomplete observations. Journal of the American Statistical Association. 1958;53(282):457-81.
5.
Greenwood M. The errors of sampling of the survivorship tables. Reports on Public Health and Statistical Subjects. 1926;33:1-26.
6.
Freireich EJ, Gehan E, Frei III E, Schroeder LR, Wolman IJ, Anbari R, et al. The effect of 6-mercaptopurine on the duration of steroid-induced remissions in acute leukemia: A model for evaluation of other potentially useful therapy. Blood. 1963;21(6):699-716.
7.
Mantel N. Evaluation of survival data and two new rank order statistics arising in its consideration. Cancer Chemotherapy Reports. 1966;50(3):163-70.
8.
Peto R, Peto J. Asymptotically efficient rank invariant test procedures. Journal of the Royal Statistical Society: Series A (General). 1972;135(2):185-98.
9.
Nelson W. Theory and applications of hazard plotting for censored failure data. Technometrics. 1972;14(4):945-66.
10.
Aalen OO. A model for nonparametric regression analysis of counting processes. Lecture Notes in Statistics. 1980;2:1-25.
11.
Breslow NE. Covariance analysis of censored survival data. Biometrics. 1974;30(1):89-99.
12.
Cox DR. Regression models and life-tables. Journal of the Royal Statistical Society: Series B (Methodological). 1972;34(2):187-202.
13.
Cox DR. Partial likelihood. Biometrika. 1975;62(2):269-76.
14.
Therneau TM, Grambsch PM. Modeling survival data: extending the Cox model. Springer Science & Business Media; 2000.
15.
Schoenfeld D. Partial residuals for the proportional hazards regression model. Biometrika. 1982;69(1):239-41.
16.
Andersen PK, Gill RD. Cox’s regression model for counting processes: a large sample study. The Annals of Statistics. 1982;10(4):1100-20.
17.
Fine JP, Gray RJ. A proportional hazards model for the subdistribution of a competing risk. Journal of the American Statistical Association. 1999;94(446):496-509.
18.
Gray RJ. A class of K-sample tests for comparing the cumulative incidence of a competing risk. The Annals of Statistics. 1988;16(3):1141-54.
19.
Therneau TM. coxme: Mixed Effects Cox Models [Internet]. 2022. Disponible en: https://CRAN.R-project.org/package=coxme
20.
Kassambara A, Kosinski M, Biecek P. survminer: Drawing Survival Curves using ’ggplot2’ [Internet]. 2021. Disponible en: https://CRAN.R-project.org/package=survminer
21.
Jackson C. flexsurv: A Platform for Parametric Survival Modeling in R. Journal of Statistical Software. 2016.
22.
Harrell Jr FE. Regression modeling strategies: with applications to linear models, logistic and ordinal regression, and survival analysis. 2.ª ed. Springer; 2015.
23.
Gray B. cmprsk: Subdistribution Analysis of Competing Risks [Internet]. 2014. Disponible en: https://CRAN.R-project.org/package=cmprsk
13 Apéndice A: Código R completo
# ============================================================
# ============================================================

# 1. INSTALACIÓN DE PAQUETES --------------------------------
install.packages(c("survival", "survminer", "flexsurv",
                   "KMsurv", "cmprsk", "rms", "ggplot2"))

# 2. CARGA DE LIBRERÍAS -------------------------------------
library(survival)
library(survminer)
library(flexsurv)
library(KMsurv)
library(cmprsk)
library(rms)
library(ggplot2)

# 3. ANÁLISIS NO PARAMÉTRICO --------------------------------
# Datos de ejemplo
data(aml, package = "survival")

# Kaplan-Meier
km_fit <- survfit(Surv(time, status) ~ x, data = aml)
summary(km_fit)

# Gráfico
ggsurvplot(km_fit, data = aml, pval = TRUE, conf.int = TRUE)

# Test de log-rank
survdiff(Surv(time, status) ~ x, data = aml)

# 4. MODELOS PARAMÉTRICOS -----------------------------------
# Exponencial
exp_fit <- survreg(Surv(time, status) ~ x, data = aml,
                   dist = "exponential")

# Weibull
weib_fit <- survreg(Surv(time, status) ~ x, data = aml,
                    dist = "weibull")

# Log-normal
lognorm_fit <- survreg(Surv(time, status) ~ x, data = aml,
                       dist = "lognormal")

# Comparar modelos
AIC(exp_fit, weib_fit, lognorm_fit)

# 5. MODELO DE COX ------------------------------------------
data(lung, package = "survival")
lung <- na.omit(lung)

# Ajuste
cox_fit <- coxph(Surv(time, status) ~ age + sex + ph.ecog,
                 data = lung)
summary(cox_fit)

# Diagnóstico
cox.zph(cox_fit)
plot(cox.zph(cox_fit))

# 6. PREDICCIÓN ---------------------------------------------
# Definir perfil
nuevo_paciente <- data.frame(age = 60, sex = 1, ph.ecog = 1)

# Predecir
pred <- survfit(cox_fit, newdata = nuevo_paciente)
plot(pred)

# Probabilidad a 1 año
summary(pred, times = 365)
14 Apéndice B: Fórmulas matemáticas
14.1 Funciones fundamentales
| Función | Definición | Relación con las demás |
|---|---|---|
| Supervivencia | \(S(t)=P(T>t)=1-F(t)\) | \(S(t)=\exp(-H(t))\) |
| Densidad | \(f(t)=\dfrac{dF(t)}{dt}=-\dfrac{dS(t)}{dt}\) | \(f(t)=h(t)S(t)\) |
| Riesgo (hazard) | \(h(t)=\dfrac{f(t)}{S(t)}\) | \(h(t)=-\dfrac{d}{dt}\log S(t)\) |
| Riesgo acumulado | \(H(t)=\displaystyle\int_0^t h(u)\,du\) | \(H(t)=-\log S(t)\) |
14.2 Estimadores no paramétricos
Kaplan-Meier (supervivencia):
\[\hat{S}(t)=\prod_{j:\,t_j\le t}\left(1-\frac{d_j}{n_j}\right)\]
Varianza de Greenwood:
\[\widehat{\text{Var}}[\hat{S}(t)]=\hat{S}(t)^2\sum_{j:\,t_j\le t}\frac{d_j}{n_j(n_j-d_j)}\]
Nelson-Aalen (riesgo acumulado):
\[\hat{H}_{NA}(t)=\sum_{j:\,t_j\le t}\frac{d_j}{n_j}\]
Riesgo acumulado vía Kaplan-Meier:
\[\hat{H}_{KM}(t)=-\log\hat{S}_{KM}(t)\]
14.3 Intervalos de confianza para \(S(t)\)
Método lineal:
\[\hat{S}(t)\pm z_{\alpha/2}\,\widehat{\text{SE}}[\hat{S}(t)]\]
Método log-log (vía método delta):
\[\hat{S}(t)^{\exp\left(\pm\, z_{\alpha/2}\, \dfrac{\widehat{\text{SE}}[\hat{S}(t)]}{\hat{S}(t)\,|\log \hat{S}(t)|}\right)}\]
14.4 Distribuciones comunes
| Distribución | \(h(t)\) | \(S(t)\) | Parámetros |
|---|---|---|---|
| Exponencial | \(\lambda\) | \(\exp(-\lambda t)\) | \(\lambda > 0\) |
| Weibull | \(\lambda \gamma t^{\gamma-1}\) | \(\exp(-\lambda t^\gamma)\) | \(\lambda, \gamma > 0\) |
| Log-normal | \(\frac{\phi\left(\frac{\log t - \mu}{\sigma}\right)}{\sigma t \left[1 - \Phi\left(\frac{\log t - \mu}{\sigma}\right)\right]}\) | \(1 - \Phi\left(\frac{\log t - \mu}{\sigma}\right)\) | \(\mu \in \mathbb{R}, \sigma > 0\) |
| Log-logística | \(\frac{\lambda \gamma t^{\gamma-1}}{1 + \lambda t^\gamma}\) | \(\frac{1}{1 + \lambda t^\gamma}\) | \(\lambda, \gamma > 0\) |
14.5 Modelo de Cox
\[h(t\mid \mathbf{X})=h_0(t)\exp(\boldsymbol{\beta}'\mathbf{X})\]
Hazard ratio para un incremento de una unidad en \(X_k\):
\[\text{HR}_k=\frac{h(t\mid X_k+1)}{h(t\mid X_k)}=\exp(\beta_k)\]
Estimador de Breslow (hazard basal acumulado):
\[\hat{H}_0(t)=\sum_{j:\,t_j\le t}\frac{d_j}{\sum_{i\in R(t_j)}\exp(\hat{\boldsymbol{\beta}}'\mathbf{X}_i)}\]
14.6 Tests estadísticos
14.6.1 Test de log-rank
\[\chi^2 = \frac{(O_1 - E_1)^2}{E_1} + \frac{(O_2 - E_2)^2}{E_2} \sim \chi^2_1\]
14.6.2 Test de Wald
Para \(H_0: \beta_j = 0\):
\[z = \frac{\hat{\beta}_j}{\widehat{\text{SE}}(\hat{\beta}_j)} \sim N(0, 1)\]
14.6.3 Test de razón de verosimilitud
\[-2 \log \Lambda = -2[\log L(\text{modelo restringido}) - \log L(\text{modelo completo})] \sim \chi^2_q\]
donde \(q\) es la diferencia en número de parámetros.
Información de la sesión:
sessionInfo()R version 4.6.0 (2026-04-24)
Platform: x86_64-apple-darwin20
Running under: macOS Monterey 12.7.6
Matrix products: default
BLAS: /Library/Frameworks/R.framework/Versions/4.6-x86_64/Resources/lib/libRblas.0.dylib
LAPACK: /Library/Frameworks/R.framework/Versions/4.6-x86_64/Resources/lib/libRlapack.dylib; LAPACK version 3.12.1
locale:
[1] en_US.UTF-8/en_US.UTF-8/en_US.UTF-8/C/en_US.UTF-8/en_US.UTF-8
time zone: Europe/Madrid
tzcode source: internal
attached base packages:
[1] grid stats graphics grDevices utils datasets methods
[8] base
other attached packages:
[1] forestplot_3.2.0 abind_1.4-8 checkmate_2.3.4 glmnet_5.1
[5] Matrix_1.7-6 mice_3.19.0 cmprsk_2.2-12 rms_8.1-1
[9] Hmisc_5.3-0 knitr_1.52 dplyr_1.2.1 KMsurv_0.1-6
[13] flexsurv_2.3.2 survminer_0.5.2 ggpubr_1.0.0 ggplot2_4.0.3
[17] survival_3.8-12
loaded via a namespace (and not attached):
[1] Rdpack_2.6.6 gridExtra_2.3.1 sandwich_3.1-3
[4] rlang_1.3.0 magrittr_2.0.5 multcomp_1.4-32
[7] otel_0.2.0 polspline_1.1.25 compiler_4.6.0
[10] vctrs_0.7.3 quantreg_6.1 quadprog_1.5-8
[13] stringr_1.6.0 pkgconfig_2.0.3 shape_1.4.6.1
[16] fastmap_1.2.0 backports_1.5.1 labeling_0.4.3
[19] deSolve_1.42 rmarkdown_2.32 nloptr_2.2.1
[22] MatrixModels_0.5-4 purrr_1.2.2 xfun_0.60
[25] jomo_2.7-6 jsonlite_2.0.0 mstate_0.3.3
[28] pan_2.0 broom_1.0.13 cluster_2.1.8.3
[31] R6_2.6.1 stringi_1.8.9 RColorBrewer_1.1-3
[34] car_3.1-5 boot_1.3-32 rpart_4.1.27
[37] numDeriv_2016.8-1.1 Rcpp_1.1.2 iterators_1.0.14
[40] zoo_1.9-0 base64enc_0.1-6 splines_4.6.0
[43] nnet_7.3-21 tidyselect_1.2.1 rstudioapi_0.19.0
[46] yaml_2.3.12 ggtext_0.2.0 codetools_0.2-20
[49] lattice_0.23-1 tibble_3.3.1 withr_3.0.3
[52] S7_0.2.2 evaluate_1.0.5 foreign_0.8-91
[55] xml2_1.6.0 muhaz_1.2.6.5 pillar_1.11.1
[58] carData_3.0-6 stats4_4.6.0 foreach_1.5.2
[61] reformulas_0.4.4 generics_0.1.4 scales_1.4.0
[64] minqa_1.2.8 glue_1.8.1 tools_4.6.0
[67] data.table_1.18.6.1 lme4_2.0-6 SparseM_1.84-2
[70] ggsignif_0.6.4 mvtnorm_1.4-2 tidyr_1.3.2
[73] rbibutils_2.4.1 colorspace_2.1-3 nlme_3.1-171
[76] htmlTable_2.5.0 Formula_1.2-6 cli_3.6.6
[79] gtable_0.3.6 rstatix_1.1.0 digest_0.6.39
[82] TH.data_1.1-5 htmlwidgets_1.6.4 farver_2.1.2
[85] htmltools_0.5.9 lifecycle_1.0.5 mitml_0.4-5
[88] statmod_1.5.2 gridtext_0.1.6 MASS_7.3-66